 NomaDamas
- 한국어와 영어 나레이션을 내 목소리로 만들려면 Qwen3-TTS Base부터 권합니다. 제가 쓰는 목소리와 짧은 대본에서는 Qwen이 가장 마음에 들었습니다.
- VoxCPM2, Higgs TTS 3, MOSS-TTS, Fish Audio Drama 3도 같은 대본으로 생성했습니다. 아래에서 약 1분 분량의 한국어 음성과 짧은 영어 샘플을 들을 수 있습니다.
- Apple Silicon Mac에서 시작하는 방법과 내 목소리를 복제하는 방법도 정리했습니다.
쇼츠 대본에서 문장 하나를 바꾸면 나레이션도 다시 녹음해야 합니다. 발표 영상이나 제품 시연을 만들 때도 비슷합니다. 대본을 고칠 때마다 내 목소리로 음성 파일을 만들 수 있다면 어떨까요?
로컬 TTS(Text-to-Speech, 문자를 음성으로 바꾸는 기술)는 모델을 내 컴퓨터에 받아 실행하는 방식입니다. 이 글은 한국어와 영어 나레이션을 만들려는 분이 첫 모델을 고를 수 있도록, 음성 복제가 가능한 다섯 모델의 결과와 실행 조건을 정리했습니다.
 로고 출처: Qwen, OpenBMB, Boson AI, OpenMOSS, Fish Audio.
로컬 TTS로 무엇을 할 수 있나요?
대본을 넣으면 WAV 같은 음성 파일이 나옵니다. 그 파일을 영상 편집기에 넣어 나레이션으로 쓸 수 있습니다. 모델에 따라 준비된 목소리를 고르거나, 녹음한 음성을 참고해 비슷한 목소리로 새 문장을 읽히는 음성 복제도 가능합니다.
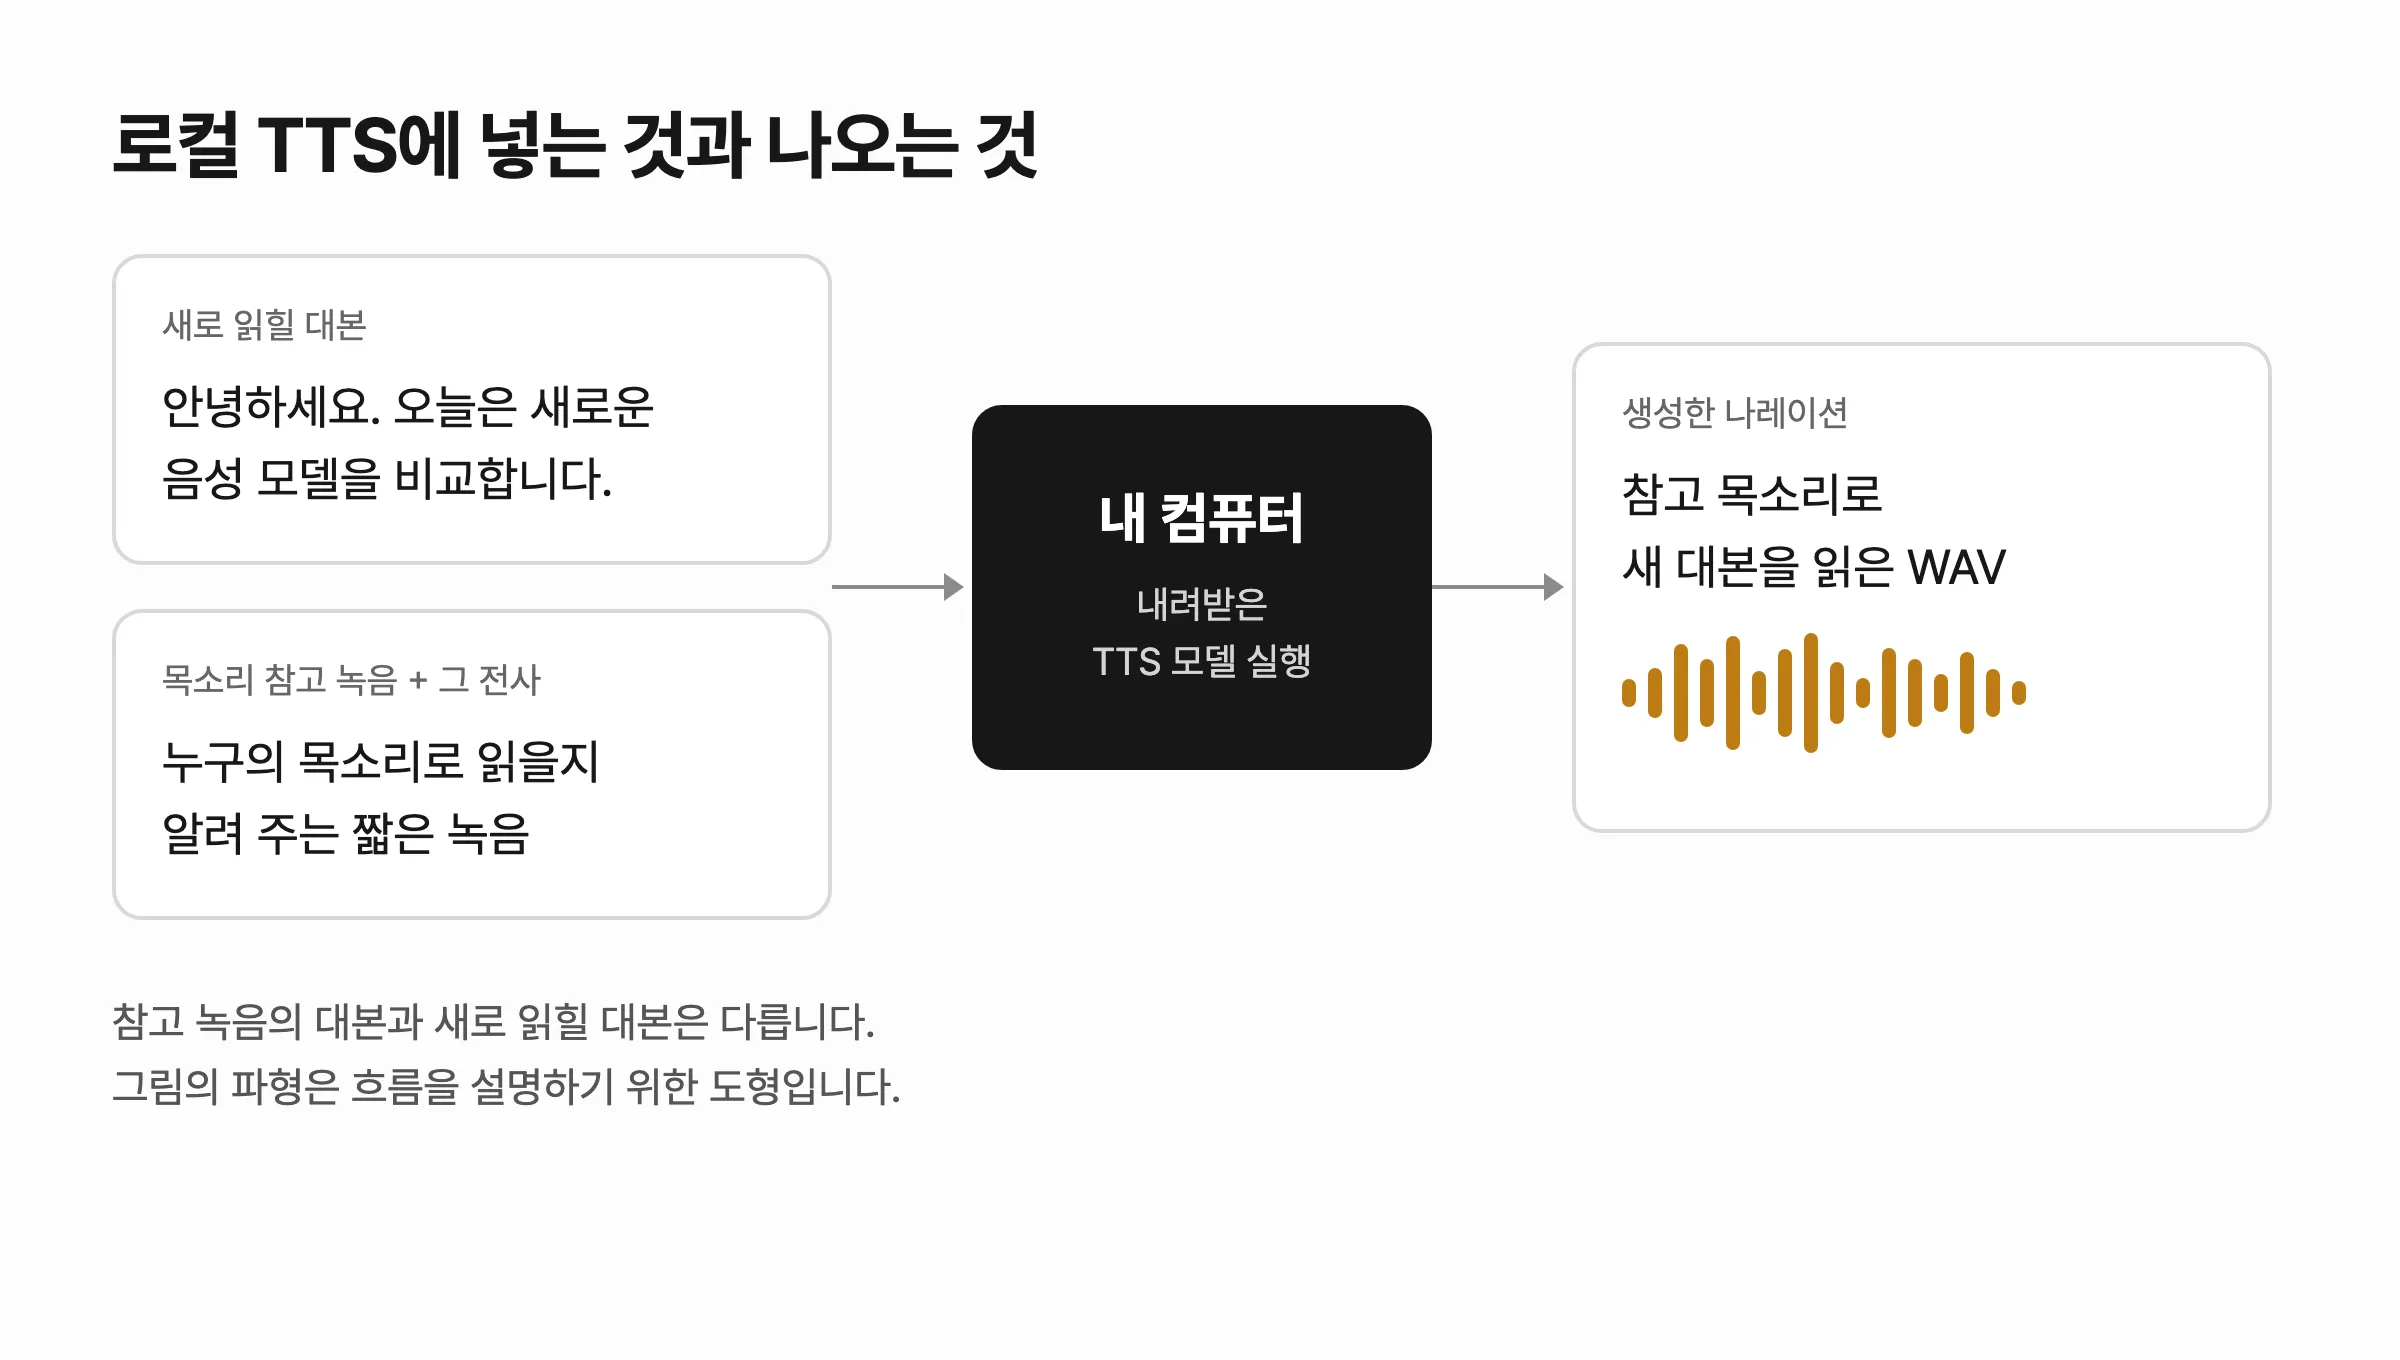 이번 비교는 참고 녹음으로 목소리를 복제하는 방식입니다. 원본 녹음과 새로 읽힐 대본은 서로 다릅니다.
아래 샘플은 모델을 내려받아 제 컴퓨터에서 만들었습니다. 같은 목소리의 녹음을 넣었을 때 각 모델이 어떻게 읽는지 들어볼 수 있습니다.
처음 하나 설치한다면 Qwen3-TTS
출처: Qwen3-TTS 공식 저장소.
저는 한국어와 영어 나레이션용 첫 로컬 TTS로 Qwen3-TTS를 권합니다. 원래 사용하던 모델이고, 다른 후보를 써 본 뒤에도 제 목소리로 만든 나레이션은 Qwen이 가장 마음에 들었습니다.
Qwen3-TTS에는 용도가 다른 모델이 있습니다. Base는 녹음을 넣어 목소리를 복제할 때, CustomVoice는 준비된 화자를 고를 때, VoiceDesign은 원하는 목소리를 글로 설명할 때 쓰는 모델입니다. 한국어와 영어는 공식 지원 언어에 포함됩니다. 공식 모델 설명
약 1분의 한국어와 짧은 영어 샘플
한국어는 TTS가 무엇인지 설명하는 대본입니다. 다른 네 모델에도 같은 대본을 넣었습니다.
한국어 공통 대본 펼쳐 보기
티티에스는 글자를 사람의 목소리처럼 읽어 주는 기술입니다.
휴대전화가 문자를 읽어 주거나, 내비게이션이 길을 안내할 때 들어 보셨을 거예요.
원하는 문장을 입력하고 목소리를 고르면, 직접 녹음하지 않아도 음성 파일을 만들 수 있습니다.
요즘은 문장의 흐름에 맞춰 쉬어 가고, 말끝의 높낮이도 자연스럽게 바꿔 줍니다.
동영상 나레이션을 만들거나, 긴 글을 귀로 듣거나, 안내 방송을 준비할 때 쓸 수 있죠.
대본을 고치면 바뀐 문장만 다시 만들 수 있어서 편리합니다.
내 목소리로 녹음한 짧은 파일을 참고해, 비슷한 목소리로 새 문장을 읽게 할 수도 있습니다.
이런 기능을 목소리 복제라고 합니다.
인터넷 서비스로 이용할 수도 있고, 내 컴퓨터에서 직접 실행할 수도 있습니다.
지금 들으시는 목소리도 같은 대본을 음성 모델에 넣어서 만든 결과입니다.
어떤 목소리가 가장 자연스럽고 오래 듣기 편한지 비교해 보세요.
한국어, 52초
영어 대본입니다. 목소리 참고 녹음은 한국어입니다.
Hello. Today we are comparing new voice models.
다섯 모델에 같은 6초 녹음을 넣었습니다. 비교하기 쉽도록 재생 음량을 맞췄습니다.
다른 로컬 TTS 모델도 들어보면
Qwen 결과가 마음에 들더라도 다른 모델로 같은 대본을 읽혀볼 이유는 있습니다. 내 목소리와 얼마나 닮았는지, 문장 끝이 어떻게 내려가는지, 영어 발음이 어떤지는 모델 이름이나 지원 언어 수만으로 고르기 어렵습니다.
아래 네 모델에도 같은 한국어와 영어 대본을 읽혀봤습니다.
VoxCPM2
VoxCPM2는 OpenBMB의 다국어 음성 생성 모델입니다. 음성 복제와 원하는 목소리를 설명해 만드는 목소리 설계 기능을 제공합니다.
한국어, 71초
영어
Qwen과 목소리의 닮은 정도나 말의 리듬이 다르게 들린다면, 실제로 쓸 대본 몇 줄을 더 넣어 볼 후보입니다.
Higgs TTS 3
출처: Boson AI 공식 사이트.
Higgs TTS 3는 Boson AI의 음성 생성 모델입니다. 아래에서 같은 대본을 읽은 한국어와 영어 음성을 들어볼 수 있습니다.
 출처:
한국어, 56초
영어
이 절의 음성은 Boson AI의 Higgs Audio, Higgs TTS 3로 생성했습니다.
같은 문장을 읽어도 멈추는 위치나 끝음이 달라질 수 있습니다. 영상에 넣을 때는 화면에 맞는 말의 속도인지도 들어볼 수 있습니다.
MOSS-TTS 1.5 Local Transformer
MOSS-TTS에도 제 녹음을 넣어 한국어와 영어 나레이션을 만들었습니다. 사용한 모델은 MOSS-TTS 1.5 Local Transformer입니다.
한국어, 64초
영어
Fish Audio Drama 3
출처: Fish Audio 공식 문서.
Fish Audio Drama 3도 한국어와 영어 나레이션을 만들 수 있습니다. 이번에 받은 모델 파일은 약 24.6GB입니다.
 출처:
모든 문장에 제 녹음을 넣었습니다. 그런데 약 1분짜리 한국어 나레이션을 들어보니 중간중간 다른 사람의 목소리처럼 들렸습니다.
한국어, 58초
영어
Built with Fish Audio. 이 절의 음성은 Fish Audio Drama 3로 생성했습니다.
내 컴퓨터에서 돌아갈까요?
이번에는 M5 Pro, 메모리 48GB Mac에서 다섯 모델을 실행했습니다. 처음 시작한다면 Qwen3-TTS 하나를 설치해 짧은 문장부터 만들어 보세요.
모델 파일을 저장할 디스크 공간과 실행할 메모리가 필요합니다. 여러 모델을 한꺼번에 띄울 필요 없이, 하나씩 실행해 음성을 비교하면 됩니다.
Mac에서 첫 음성을 만들어 보려면
Apple Silicon Mac에서는 MLX-Audio로 Qwen3-TTS를 실행할 수 있습니다. Claude Code(클로드 코드)나 Codex(코덱스)를 이미 쓴다면 설치와 첫 음성 생성을 한국어로 부탁할 수 있습니다.
- 배경음이나 다른 사람의 말이 겹치지 않는 본인 녹음을
ref.wav로 준비합니다. 이번 비교에서는 6초 녹음을 썼습니다. - 그 녹음에서 말한 내용을 받아써 같은 폴더의
ref.txt에 저장합니다. 새로 읽힐 대본은 별도로 넣습니다. - 그 폴더에서 에이전트를 열고 아래 문장을 붙여 넣습니다.
이 컴퓨터에서 한국어와 영어 나레이션을 만들고 싶어.
운영체제, 칩, 메모리와 남은 디스크 공간을 먼저 확인해 줘.
Qwen3-TTS를 공식 문서와 MLX-Audio 문서에 맞춰 별도 환경에 설치할 수 있는지 봐 줘.
내 목소리를 복제할 때는 Base 모델을 사용하고, 내 컴퓨터에 있는 ref.wav와 ref.txt를 읽게 해 줘.
녹음과 전사는 외부 서비스에 보내지 말고, 설치 용량과 실행 계획부터 알려 줘.
준비되면 짧은 한국어 한 문장을 WAV로 만들고 생성된 파일을 확인해 줘.
이미 MLX-Audio가 설치돼 있다면 아래는 이번 Qwen 실행에 사용한 모델 식별자와 언어 값입니다. --ref_text에는 예시 문구 대신 본인 녹음의 실제 내용을 넣어 주세요.
python -m mlx_audio.tts.generate \
  --model mlx-community/Qwen3-TTS-12Hz-1.7B-Base-bf16 \
  --text "안녕하세요. 오늘은 새로운 음성 모델을 비교합니다." \
  --lang_code Korean \
  --ref_audio ./ref.wav \
  --ref_text "여기에 ref.wav에서 말한 내용을 적어 주세요." \
  --max_tokens 256 \
  --audio_format wav \
  --output_path ./output
영어를 만들 때는 대본을 영어로 바꾸고 언어 값을 English로 지정하면 됩니다. 완성된 WAV는 output 폴더에서 열어 들어볼 수 있습니다.
어떤 기준으로 고르면 좋을까요?
처음 시작한다면 Qwen3-TTS에 실제로 쓸 한국어와 영어 대본부터 넣어 보세요. 마음에 들지 않는 문장이 있을 때 다른 후보로 같은 문장을 만들어 보면 차이를 듣기 쉽습니다.
| 하려는 일 | 들어볼 부분 |
|---|---|
| 한국어 영상 나레이션 | 문장 끝, 조사, 띄어 읽는 위치 |
| 영어 나레이션 | 발음, 강세, 한국어 참고 음성의 특징이 얼마나 남는지 |
| 내 목소리 복제 | 원래 목소리와 닮았는지, 긴 대본에서도 같은 목소리로 이어지는지 |
| 자주 고치는 짧은 영상 | 한 문장을 다시 만드는 데 걸리는 시간 |
| 감정이 있는 대사 | 원하는 감정과 속도를 조절할 수 있는지 |
짧은 테스트 문장이 마음에 들면 실제로 쓸 고유명사, 숫자, 한국어와 영어가 섞인 문장을 한 문단 분량으로 넣어 보세요. 그 대본까지 만족스럽게 읽어 주는 모델을 고르면 됩니다.
자주 묻는 질문
로컬 TTS는 무료인가요?
이 글의 샘플은 외부 TTS API 이용료 없이 만들었습니다. 상업 이용 조건은 모델마다 다르므로 각 모델의 라이선스를 확인해 주세요.
한국어와 영어를 같은 목소리로 만들 수 있나요?
Qwen3-TTS Base에 같은 한국어 참고 녹음을 넣어 두 언어의 음성을 만들었습니다. 위의 한국어와 영어 샘플에서 목소리를 들어볼 수 있습니다.
어떤 컴퓨터에서나 쓸 수 있나요? / Can I run local TTS on any PC?
이 글의 따라 하기는 Apple Silicon Mac을 기준으로 합니다. 다른 컴퓨터에서는 사용하려는 모델의 공식 설치 안내를 확인해 주세요.
참고 자료
- Qwen3-TTS 공식 모델과 실행 안내
- VoxCPM2 공식 프로젝트
- Higgs TTS 3 공식 모델
- MOSS-TTS Local Transformer 공식 모델
- Fish Audio Drama 3 공식 모델
- MLX-Audio, 이번 대안 모델에 사용한 소스 버전
- Drama 3용 audio.cpp 실행 안내, 사용한 GGUF 변환본
2026-10-20 업데이트: 한국어 샘플을 약 1분 분량으로 바꾸고 Drama 3에서 목소리가 달라졌던 경험을 추가했습니다.
이 글은 AI의 도움을 받아 작성했습니다.