 NomaDamas
9월 중순부터 한동안 AI 소식에 Jev(제브)라는 이름이 자주 보였습니다. 개발자 커뮤니티 해커뉴스에 올라온 발표 글은 1,989점을 받았습니다. 해커뉴스 점수는 회원들이 누른 추천으로 쌓입니다. 2026년 들어 해커뉴스에 올라온 글 28만여 개 가운데 이보다 점수가 높은 글은 36개뿐입니다(10월 7일 기준). 한국어 X 글과 링크드인 글에도 “요즘 난리난 Jev”, “요즘 난리인 Jev” 같은 말이 올라왔습니다. 그런데 소개를 읽어 보면 고개가 갸웃해집니다. 글도 안 쓰고 요약도 안 하고 코드도 안 짜는 AI라고 합니다. 그럼 어디에 쓰는 걸까요?
이 글은 Jev가 무엇인지 궁금한 개발자와, 메일 분류처럼 매일 반복하는 판단을 AI에게 맡겨 보고 싶은 실무자를 위해 썼습니다. 맡긴다면 어디까지 믿어도 되는지 보려고 가상 회사의 대표 메일함에 쌓인 한국어 메일 120통을 Jev와 OpenAI의 GPT-6 Luna에 똑같이 맡겨 봤습니다. 터미널 명령 몇 줄과 한국어 부탁 문장으로 Claude Code(클로드 코드)에서 따라 하는 Jev 사용법도 담았습니다.
요약
- Jev(제브)는 TypeSafe AI가 2026년 9월 15일에 공개한 AI 모델입니다. 글을 쓰지 않고 미리 정해 둔 질문에 보기마다 확률을 매겨 답합니다. 많은 양을 빠르고 싸게 나누고 얼마나 확신하는지를 숫자로 알려 주는 AI입니다.
- 한국어 메일 120통을 Jev와 GPT-6 Luna에 같은 질문으로 분류시켰습니다. Jev는 10배 빨랐고(4.5초 대 48.3초) 비용은 약 절반이었습니다(0.0070달러 대 0.0146달러). 대신 메일 종류는 95.0%를 맞혀 GPT-6 Luna(100%)보다 낮았고 틀린 6통 중 5통이 사기 메일이었습니다.
- 메일 종류 확신도가 0.9 미만인 14통만 사람에게 넘기자 Jev가 처리한 106통 중 105통이 맞았습니다(1회차). 남은 1통은 Jev가 확신도 0.99로 틀린 사기 메일이었습니다. 사기인지 따로 물었을 때도 이 메일의 사기 확률은 12%여서 기준선을 10%까지 내려야 잡혔습니다. 그러면 정상 메일 3통도 사기로 걸립니다. 그 숫자를 보고 어디까지 맡길지는 사람이 정해야 합니다.
Jev(제브)란?
Jev(제브)는 미국 스타트업 TypeSafe AI가 2026년 9월 15일에 얼리 액세스로 공개한 AI 모델입니다. 회사는 Jev를 ‘System One 모델’이라는 새 종류의 첫 모델로 소개합니다.
ChatGPT 같은 LLM(대형 언어 모델)은 질문을 받으면 답을 토큰(글자 조각) 단위로 하나씩 이어 씁니다. Jev는 글을 쓰지 않습니다. 메일 같은 자료와 질문을 받으면 미리 정해 둔 보기마다 확률을 매겨 돌려줍니다. 홈페이지가 내건 문구도 “Decisions, not strings”(문장 말고 판단)입니다.
같은 메일에 같은 보기 정의로 세 가지를 물었을 때 두 모델이 답하는 과정을 실제 걸린 시간대로 재생합니다(7초 반복, 소리 없음). LLM 쪽은 GPT-6 Luna에 답 형식을 정하지 않고 따로 한 번 물은 답입니다. Jev 쪽은 120통 실측에서 이 메일에 돌려준 답입니다. 두 시간 모두 이 메일 한 통에 걸린 값입니다. GPT-6 Luna가 토큰을 내놓은 시각은 재지 않아 85토큰을 3.9초에 고르게 나눠 그렸습니다. 2026-10-06 측정.
보기 정의를 주자 GPT-6 Luna도 ‘billing’처럼 보기 이름 하나로 답했습니다. 다만 이렇게 받은 답에는 얼마나 확신하는지가 없습니다. Jev는 보기마다 확률을 돌려주므로 “결제일 확률이 70%를 넘으면 결제 담당자에게, 아니면 사람에게”처럼 코드가 숫자를 보고 갈래를 나눌 수 있습니다. TypeSafe는 Jev를 “똑똑한 if문”이라고 부릅니다. if문은 조건에 따라 갈래를 나누는 코드입니다. Jev는 그 조건을 글로 적은 기준대로 판단해 줍니다.
질문은 세 가지 모양으로 받습니다
Jev에 던지는 질문은 세 종류이고 한 번에 여러 개를 섞어 물을 수 있습니다. 질문마다 무엇을 묻는지(instructions)와 보기마다 무엇을 뜻하는지(criteria)를 글로 적어 주면 Jev가 그 정의에 맞춰 판단합니다.
| 질문 종류 | 묻는 것 | 돌려주는 값 | 이번 메일 분류에서 |
|---|---|---|---|
| Choice | 보기 중 하나 고르기 | 보기마다 확률 | 어떤 종류인가? (고객 지원, 영업, 결제, 제휴, 채용, 뉴스레터, 사기) |
| Noul | 예 또는 아니요 | 예일 확률 하나 | 답장이 필요한가? |
| Score | 정해 둔 단계 중 어디쯤인가 | 단계마다 확률 | 얼마나 급한가? (이번 주 안에, 오늘 안에, 지금 바로) |
Noul은 동전 던지기처럼 둘 중 하나가 나오는 확률 분포인 베르누이(Bernoulli)를 줄인 이름이라고 TypeSafe CEO가 해커뉴스 댓글에서 설명했습니다. Choice와 Score의 답에는 확신도(confidence)도 붙습니다. 확률이 한 보기에 몰릴수록 1에, 여러 보기에 고르게 퍼질수록 0에 가까워지는 값입니다. Noul에는 확신도가 따로 없고 예일 확률이 그 역할을 합니다. 0.5에 가까울수록 확신하지 못한 답입니다. 확신도를 어디에 쓰는지는 실측 결과에서 다룹니다.
출력은 무료이고 입력에만 100만 토큰당 0.042달러를 받습니다. 이번 실측에서는 메일 한 통에 질문 세 개를 물을 때 평균 1,385토큰이 들어 한 통에 0.00006달러였습니다. Jev는 여러 회사의 AI 모델을 API 키 하나로 부를 수 있게 해 주는 OpenRouter에서 typesafe/jev-1.13이라는 이름으로 부를 수 있고 TypeSafe에 가입해 직접 쓸 수도 있습니다. TypeSafe 홈페이지 공지에 따르면 9월 27일부터는 대기 명단 없이 누구나 가입할 수 있습니다.
누가 왜 만들었나
TypeSafe AI 창업자 Diogo Almeida는 OpenAI에서 언어 모델이 지시를 따르고 사람과 대화하도록 만드는 방법을 만드는 데 참여했다고 공식 블로그에 적었습니다. 그 작업이 ChatGPT의 바탕이 된 연구로 이어졌다고 합니다. 회사는 2년 동안 공개하지 않고 Jev를 만들었다고 밝혔습니다.
이름은 경제학자 윌리엄 스탠리 제번스(Jevons)에서 따왔습니다. 증기기관의 효율이 좋아질수록 석탄을 더 많이 쓰게 됐다는 제번스의 역설처럼, 기계 지능이 싸질수록 쓸 곳이 훨씬 많아지리라는 뜻을 담았다고 합니다. System One이라는 분류 이름은 심리학자 대니얼 카너먼이 말한 빠르고 직관적인 생각(시스템 1)에서 왔습니다.
왜 이렇게 난리였을까?
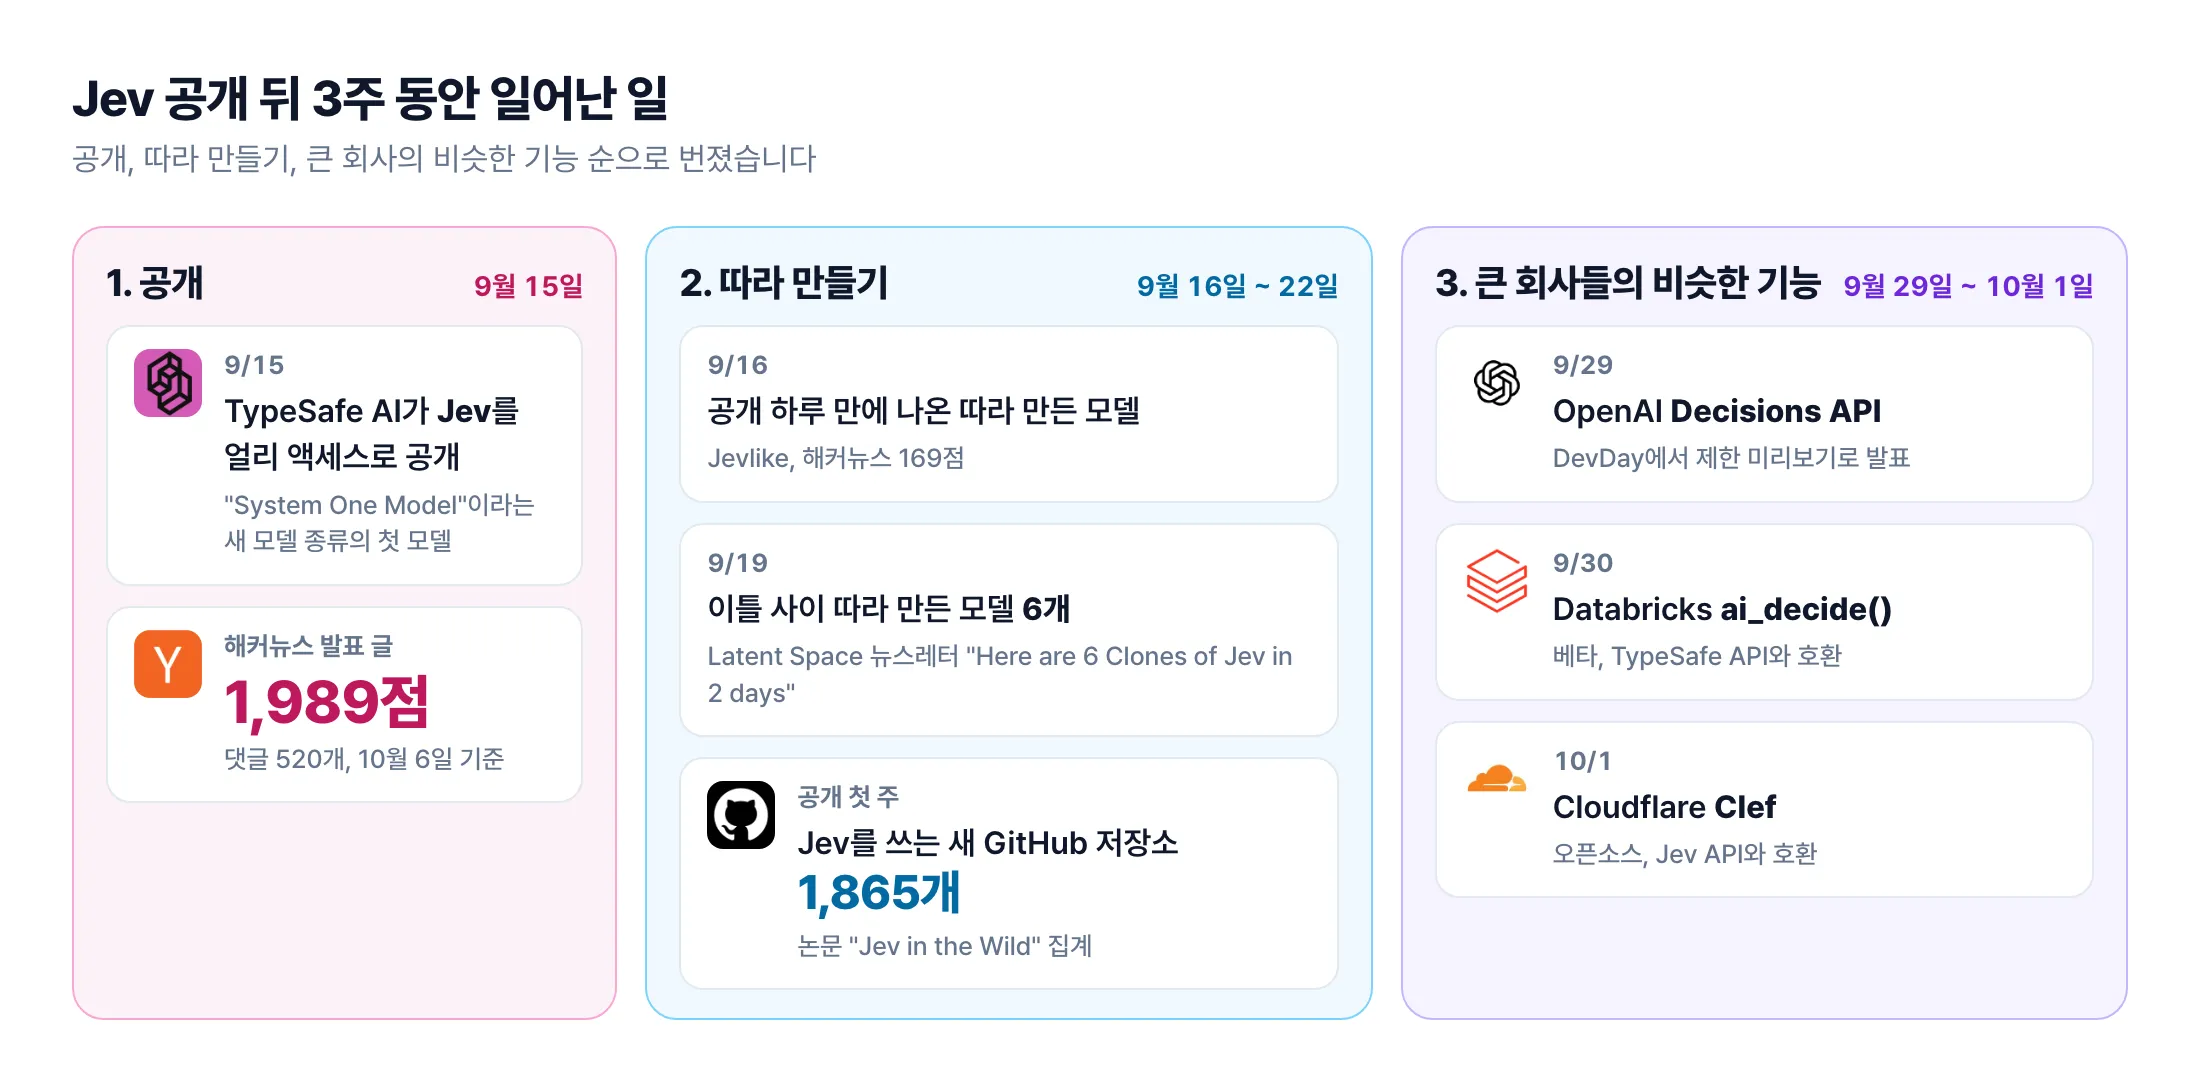 Jev 공개 뒤 3주 동안의 주요 사건입니다. 해커뉴스 점수와 댓글 수는 2026-10-06 기준입니다.
공개 하루 만에 Jev를 흉내 낸 작은 모델(Jevlike)이 해커뉴스에 올라왔습니다. 공개 나흘 뒤인 9월 19일에는 Latent Space 뉴스레터가 이틀 사이에 나온 따라 만든 모델 6개를 정리했습니다. 공개 첫 주에 Jev를 쓰는 새 GitHub 저장소가 1,865개 생겼다는 논문 집계도 나왔습니다.
2주 뒤에는 큰 회사들이 비슷한 기능을 내놓았습니다. OpenAI는 9월 29일 개발자 행사 DevDay에서 GPT-6 Luna 기반의 Decisions API를 제한 미리보기로 발표했습니다. Databricks는 9월 30일 ai_decide() 베타를 내면서 TypeSafe API와 호환된다고 밝혔습니다. Cloudflare는 10월 1일 Jev API와 호환되는 오픈소스 모델 Clef를 공개했습니다.
TypeSafe가 발표 글에 실은 비교 영상입니다(15초 반복, 소리 없음). 같은 질문 27개를 TypeSafe API와 GPT-5.6 Terra에 동시에 보낸 회사의 시연입니다. 영상 끝의 74.9배와 171.0배는 이 시연 한 번의 값입니다.
TypeSafe 홈페이지는 Jev가 193.6배 빠르고 444.6배 싸다고 내세웁니다. 회사가 만든 업무 네 가지 평가에서 나온 값입니다. 회사도 블로그에서 실제로 얻을 이득으로는 높은 쪽일 것이라고 적었습니다.
반론도 있습니다. 해커뉴스에는 작은 오픈 모델과 파이썬 25줄로 비슷한 것을 만든다는 글(“Jev in 25 Lines of Python”, 692점)이 올라왔습니다. BERT 같은 기존 분류 모델이 하던 일이라는 댓글도 있었습니다. 분류 모델은 보통 글을 정해 둔 종류로 나누도록 데이터를 모아 따로 학습시킨 모델입니다. TypeSafe CEO도 “LLM보다는 대형 분류 모델에 가깝다”는 설명에 매우 정확하다고 답했습니다. 기존 분류 모델과 다른 점으로 꼽히는 것은, 따로 학습시키지 않고 글로 쓴 기준만 바꿔 가며 물을 수 있다는 점입니다.
회사가 내세우는 “환각 0%“도 뜻을 짚어 둘 필요가 있습니다. 환각은 AI가 사실이 아닌 내용을 그럴듯하게 지어내는 것을 말합니다. 여기서 0%는 측정한 값이 아니라 정해 둔 보기 밖의 답이 나올 수 없다는 뜻입니다. CEO도 해커뉴스 댓글에서 확률 모델이라 자신 있게 틀릴 수도 있다고 인정했습니다. 이번 실측에서도 그런 메일이 나왔습니다.
한국어 메일 120통으로 직접 써 봤습니다
이렇게 재 봤습니다
회사가 내세운 배수는 회사가 고른 업무에서 나온 값입니다. 한국어 메일에서는 어떨지 직접 재 봤습니다. 가상 회사 ‘한빛랩스’의 운영팀 오유나 씨가 10월 6일 화요일 아침 8시 30분에 대표 메일함을 엽니다. 한빛랩스는 협업 도구 ‘한빛노트’를 파는 30명 규모 스타트업입니다. 메일함에는 엿새 동안 메일 120통이 쌓였습니다. 고객 문의와 결제 알림 사이에 제휴 제안, 입사 지원, 뉴스레터, 사기 메일이 섞여 있습니다.
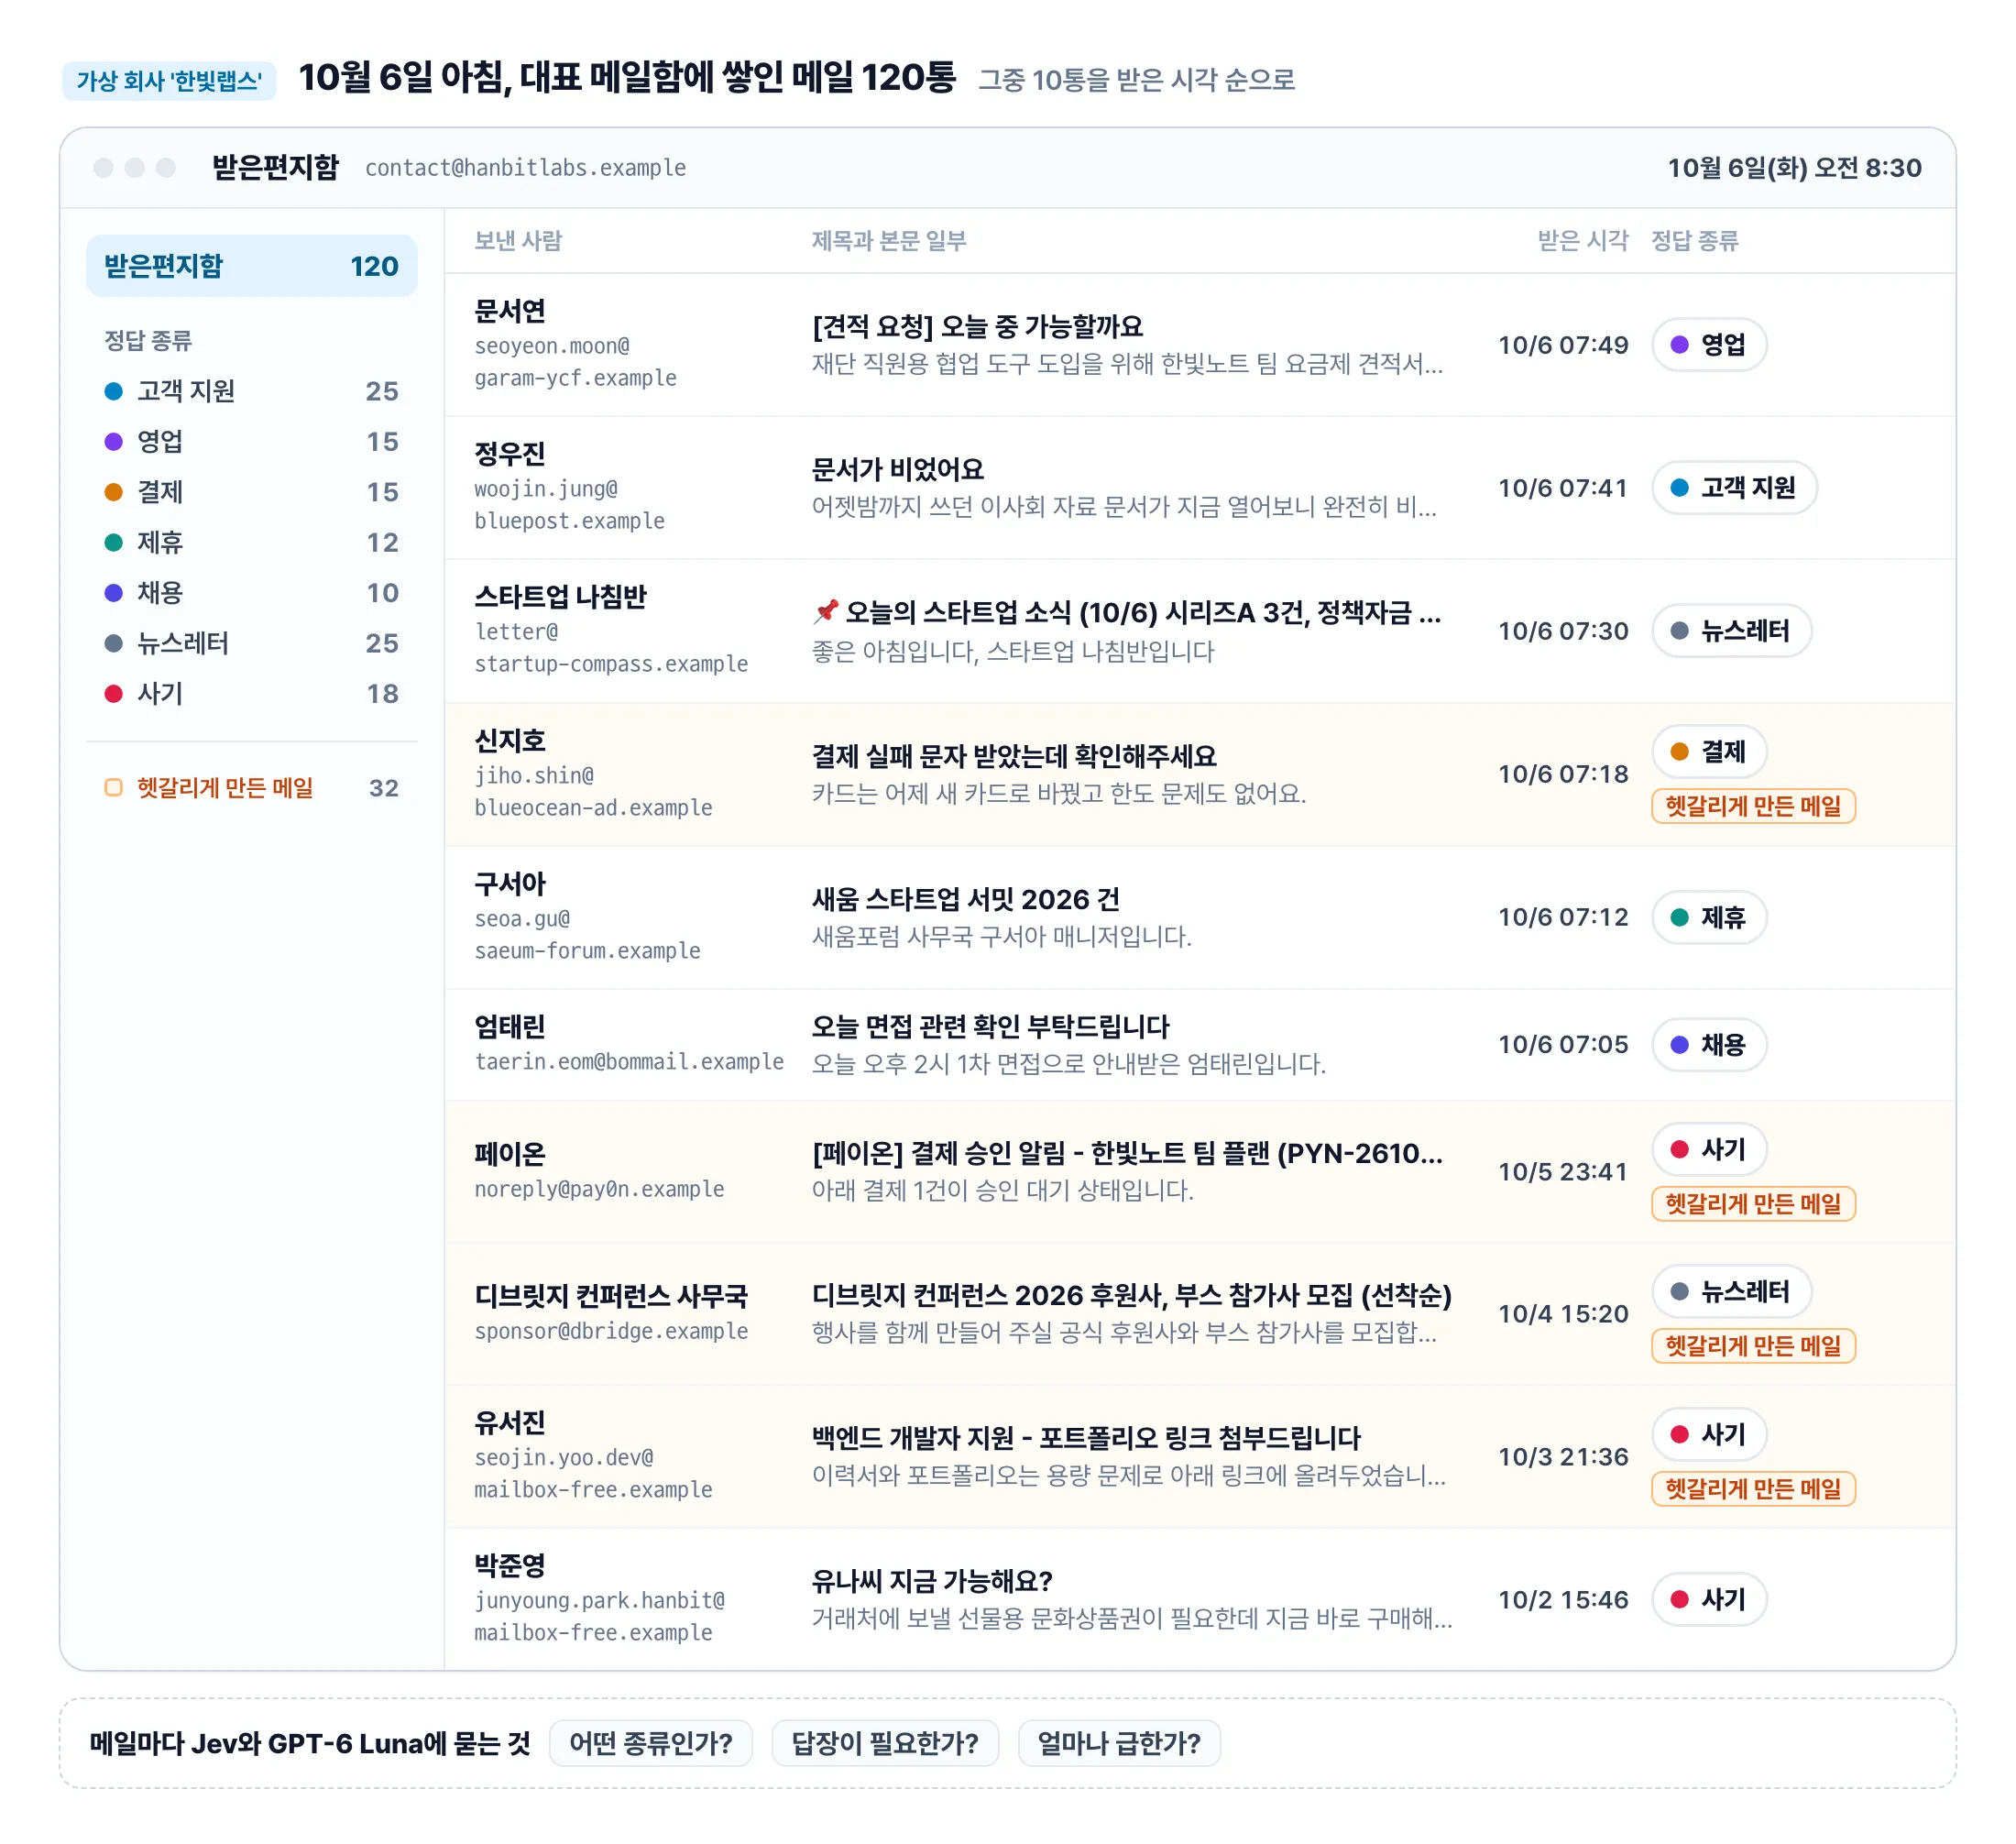 오유나 씨가 연 메일함입니다. 120통 중 일곱 종류가 모두 들어가게 10통을 골라 받은 시각 순으로 놓았습니다. 오른쪽이 정답 종류이고 주황 표시는 겉모습과 정답이 다르게 만든 메일입니다. 정답을 가린 사본을 다른 Claude 세션에 주고 정의만 보고 다시 분류하게 했더니 세 질문 모두 120통이 같았습니다.
- 메일은 Claude로 만든 한국어 합성 메일 120통입니다. 고객 지원 25, 영업 15, 결제 15, 제휴 12, 채용 10, 뉴스레터 25, 사기 18통이고 4통 중 1통꼴(32통)은 겉모습과 정답이 다르게 만들었습니다.
- 질문은 종류(7가지), 답장 필요(예, 아니요), 긴급도(3단계) 세 가지입니다. 보기마다 뜻을 한두 문장으로 정의했고 두 모델에 같은 정의를 줬습니다.
- Jev는 OpenRouter의
typesafe/jev-1.13(응답에 찍힌 버전은jev-1.13-20260917)을 불렀습니다. - GPT-6 Luna는 OpenRouter의
openai/gpt-6-luna를 불렀습니다. GPT-6 중 가장 싼 모델(100만 토큰당 입력 0.10달러, 출력 0.50달러)이고 TypeSafe 공식 평가와 독립 실험에서도 Jev와 견준 모델입니다. 같은 정의를 지시문으로 주고 답이 정해 둔 이름으로만 나오도록 답 형식(JSON)을 고정했습니다. 추론 설정은 기본값입니다. - 120통을 한 번에 8통씩 보냈고 같은 조건으로 세 번 재서 평균을 냈습니다. 2026년 10월 6일에 쟀습니다.
Jev는 얼마나 빨랐을까?
같은 메일 120통을 두 모델에 동시에 보낸 실행을 메일 한 통당 칸 하나로 그렸습니다(15초 반복, 소리 없음). 답이 온 순간 칸이 찹니다. 빨간 칸은 메일 종류를 틀린 메일입니다. 경주 6초까지는 실제 걸린 시간대로, 그 뒤는 8배속으로 재생합니다. 화면의 초는 실제 걸린 시간입니다. 이 실행(Jev 4.4초, GPT-6 Luna 53.1초)은 표의 세 번과 따로 잰 것이라 평균과 조금 다릅니다. 2026-10-06 측정.
세 번 잰 평균은 이렇습니다.
| Jev (jev-1.13) | GPT-6 Luna | |
|---|---|---|
| 메일 종류 정답 일치 | 95.0% | 100% |
| 답장 필요 정답 일치 | 91.1% | 100% |
| 긴급도 정답 일치 | 85.8% | 98.9% |
| 사기 메일을 사기로 본 수 | 13 / 18통 | 18 / 18통 |
| 120통 처리 시간 | 4.5초 | 48.3초 |
| 120통 비용 | 0.0070달러 | 0.0146달러 |
| 1,000통으로 환산한 비용 | 0.058달러 | 0.121달러 |
Jev는 10배 빨랐고 비용은 약 절반이었습니다. 메일 한 통에 걸린 시간의 중앙값은 Jev 약 0.27초, GPT-6 Luna 약 3.06초였습니다. 메일 종류 답은 두 모델 모두 세 번 내내 같았습니다. 실행마다 답이 달라진 메일은 Jev가 답장 필요 2통과 긴급도 1통, GPT-6 Luna가 긴급도 3통이었습니다. GPT-6 Luna의 비용은 실행마다 0.0133~0.0170달러로 달랐습니다.
정확도는 GPT-6 Luna가 높았습니다. Jev가 종류를 틀린 6통 중 5통이 사기 메일이었습니다.
Jev는 어떤 메일에서 틀렸을까?
Jev가 놓친 사기 메일 5통은 모두 정상 메일처럼 꾸민 메일이었습니다.
- 진짜 결제대행사와 한 글자 다른 주소(
pay0n.example)에서 온 ‘결제 승인 알림’은 결제로 봤습니다(결제 89%, 사기 11%). - 입사 지원 메일처럼 꾸며 회사 메일 계정으로 로그인하게 만드는 메일은 확신도 0.99로 채용이라고 답했습니다.
- 미납 청구서로 겁주는 가짜 송장은 결제로, 문서 열람을 핑계로 로그인을 요구하는 메일은 영업으로, 열람 기한 24시간을 건 가짜 제안서는 제휴로 봤습니다.
사기가 아닌 나머지 1통은 좌석 18개를 더 사려는 기존 고객의 메일(정답 영업)인데 Jev는 고객 지원으로 봤습니다. GPT-6 Luna는 사기 18통을 모두 사기로 봤습니다.
TypeSafe 문서도 이 약점을 적어 두었습니다. Jev는 질문을 글자 그대로 읽고(Literal reading), 판단을 흔들려고 쓴 글(Adversarial content)에 영향을 받을 수 있다고 합니다. 사기 메일은 처음부터 정상 메일로 보이려고 쓴 글입니다.
확신도를 보고 어디까지 맡길까?
사기 메일을 이렇게 놓친다면 메일함을 통째로 맡기기는 어렵습니다. 그래도 Jev가 답에 붙이는 확신도를 보면 어디까지 맡길지 고를 수 있었습니다.
확신도로 사람에게 넘길 메일을 고를 수 있습니다
TypeSafe 홈페이지에 걸린 확신도와 기준선 설명 애니메이션입니다(8초 반복, 소리 없음). 격자의 칸이 ‘아니요’(흰색)부터 ‘예’(검은색)까지 농도가 다른 색으로 차고 왼쪽 위 숫자가 기준을 통과(PASS)한 칸 수를 셉니다.
Jev는 종류처럼 보기를 고르는 답에 확신도를 붙여 줍니다. 확신도가 기준보다 낮은 메일만 사람에게 넘기면 결과가 이렇게 달라집니다(1회차 실측, 메일 종류 질문).
| 확신도 기준 | Jev가 처리한 메일 | 그중 정답 일치 | 사람에게 넘긴 메일 | 넘긴 메일 중 Jev가 틀린 것 |
|---|---|---|---|---|
| 없음 | 120통 | 95.0% | 0통 | 0통 |
| 0.5 | 118통 | 95.8% | 2통 | 1통 |
| 0.8 | 111통 | 97.3% | 9통 | 3통 |
| 0.9 | 106통 | 99.1% | 14통 | 5통 |
0.9를 기준으로 하면 14통만 사람이 보고 Jev가 처리한 106통 중 105통이 맞았습니다. Jev가 틀린 6통 중 5통이 넘긴 14통에 들어 있었습니다. 같은 조건으로 다시 잰 2회차에서는 11통을 넘기고 109통 중 106통이 맞았습니다.
남은 1통이 문제입니다. 입사 지원으로 꾸민 사기 메일을 Jev는 확신도 0.99로 채용이라고 답했습니다. 확신도는 사람에게 넘길 메일을 고르는 데 도움이 되지만 자신 있게 틀린 답까지 걸러 주지는 않습니다. 그렇다면 사기인지를 따로 물으면 이 메일도 걸러 낼 수 있을까요?
판단 하나에 질문 하나
처음 설계에서는 ‘답장이 필요한가?‘의 ‘아니요’ 정의에 “사기 메일(답하면 안 된다)“을 넣었습니다. 사기인지 판단하고 그 결과로 답장 여부를 정하는 두 판단을 질문 하나에 넣은 셈입니다.
결과는 어긋났습니다. 대표를 사칭해 문화상품권을 사 달라는 메일을 Jev는 100% 사기로 보면서도 답장이 필요하냐는 질문에는 83% 확률로 예라고 답했습니다. 본문 끝의 “확인되면 바로 답장 줘요”를 글자 그대로 읽은 것으로 보입니다. 1회차에서 답장 필요를 틀린 10통 중 9통이 사기 메일이었습니다. 그중 5통은 Jev가 종류를 사기로 맞히고도 답장이 필요하다고 본 메일이었습니다.
TypeSafe 문서는 질문 하나에 판단 여러 개를 숨기지 말고 해석이 필요하면 글자 그대로 답할 수 있는 질문 둘로 나눠 코드에서 합치라고 권합니다. 그래서 “이 메일은 받는 사람을 속이려는 사기 메일인가?”를 따로 묻고 종류 보기에서는 사기를 뺐습니다. “사기와 뉴스레터는 답장 불필요, 긴급도 최저”라는 규칙은 질문에서 빼 코드로 옮기고 다시 돌렸습니다.
| 처음 설계 | 질문을 나눈 뒤 | |
|---|---|---|
| 답장 필요 정답 일치 | 91.7% | 96.7% |
| 긴급도 정답 일치 | 85.8% | 94.2% |
| 메일 종류 정답 일치 | 95.0% | 94.2% |
두 설계 모두 1회 잰 값이라 처음 설계 열은 위의 세 번 평균 표가 아니라 1회차 값입니다. 사기 판단은 확률 50%를 기준선으로 썼습니다.
답장 필요와 긴급도는 올랐고 메일 종류는 오히려 조금 내려갔습니다. 사기 확률 50%를 기준선으로 끊었더니 사기 18통 중 12통만 사기로 잡혔기 때문입니다.
기준선은 사람이 정합니다
사기인지 따로 물었을 때 Jev가 준 확률을 메일마다 찍어 보면 이렇습니다.
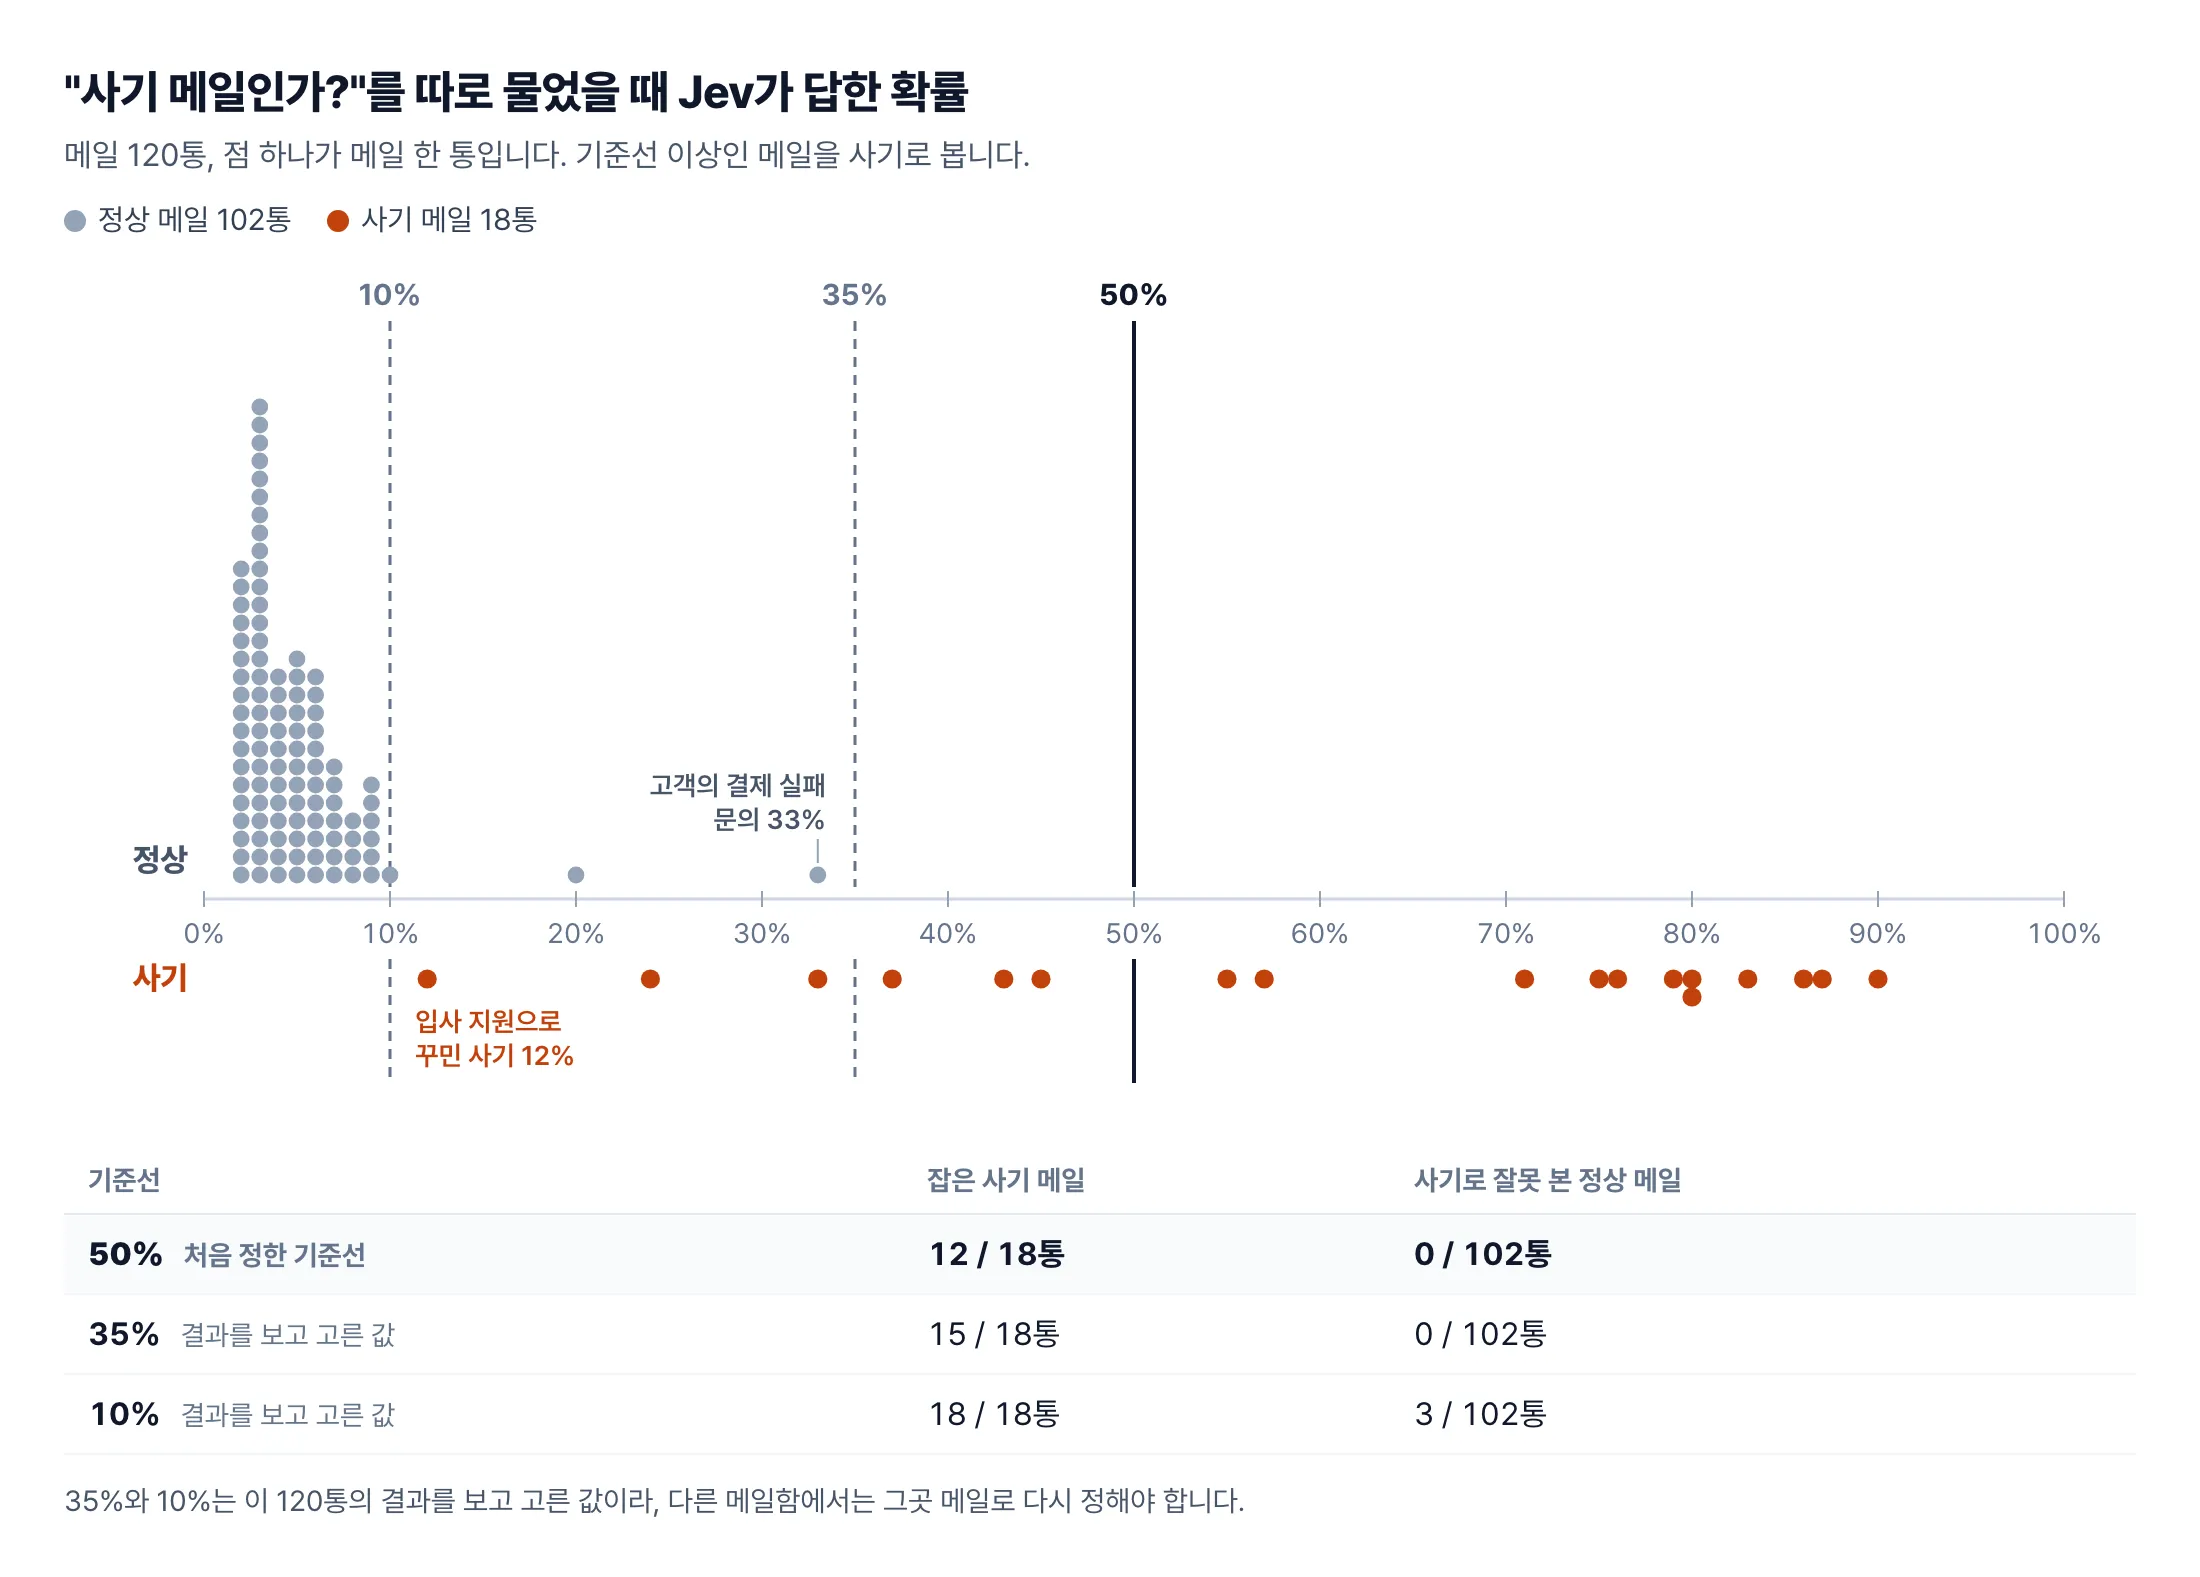 ‘사기 메일인가?‘에 Jev가 답한 확률입니다. 기준선 이상인 메일을 사기로 봅니다. 2026-10-06 측정.
정상 메일 102통 중 99통은 10% 미만이었습니다. 사기 메일 18통 중 가장 낮은 것은 입사 지원으로 꾸민 그 메일로 12%였습니다. 확률만으로도 사기와 정상이 꽤 잘 갈립니다. 문제는 어디에 선을 긋느냐입니다.
- 처음 정한 50%에서는 사기 18통 중 12통을 잡았습니다
- 35%로 내리면 15통을 잡고 정상 메일을 사기로 잘못 본 것은 여전히 0통입니다
- 10%로 내리면 그 메일까지 18통을 모두 잡지만 정상 메일 3통이 사기로 걸립니다
35%와 10%는 이 120통의 결과를 보고 고른 값이라 다른 메일함에는 맞지 않을 수 있습니다. 사기를 놓치는 비용과 정상 메일을 잘못 막는 비용 중 무엇이 더 큰지는 회사마다 다릅니다. 어느 쪽이 더 큰지 정하고 정답을 아는 내 메일 수십 통으로 먼저 재 본 뒤 선을 정하면 됩니다.
Jev 사용법: Claude Code에게 맡겨 보기
이제 직접 써 볼 차례입니다. Jev는 채팅 창에 말을 거는 AI가 아니라 프로그램이 부르는 API(프로그램끼리 주고받는 창구)입니다. TypeSafe 콘솔의 Playground에서는 가입 후 코드 없이 몇 건 넣어 볼 수 있지만 메일 수십 통을 한꺼번에 돌리려면 짧은 프로그램이 필요합니다. 코드를 짜 본 적이 없다면 Claude Code나 Codex 같은 AI 코딩 에이전트에게 한국어로 부탁하면 됩니다. 에이전트가 사용법 문서를 읽고 프로그램을 짜서 돌려 줍니다.
120통 중 20통을 엑셀에서도 열리는 CSV 파일 하나(메일.csv)로 만들어 두고 Claude Code에게 부탁해 봤습니다. 파일에는 번호, 받은 시각, 보낸 사람, 보낸 주소, 제목, 본문 열이 있습니다. 정답은 결과를 맞춰 볼 때만 따로 썼습니다.
준비물
- Claude Code. Claude 유료 요금제나 Anthropic API 결제가 필요합니다. 이 비용은 Jev 사용료와 따로 듭니다
- OpenRouter 계정과 API 키. 키는 키 발급 화면에서 만들면 됩니다. Jev 사용료는 크레딧 화면에서 충전한 금액에서 나갑니다. 이번 20통은 0.0009달러였습니다
1. 키를 넣고 Claude Code를 엽니다
API 키는 대화창에 붙여 넣지 말고 환경 변수로 넣어 두는 편이 안전합니다. 대화창에 붙인 키는 대화 기록에 남습니다. 환경 변수는 터미널이 그 안에서 실행하는 프로그램에 넘겨주는, 이름 붙은 값입니다. 터미널을 열고 cd 명령으로 메일.csv가 있는 폴더에 들어간 뒤 아래 두 줄을 입력하면 됩니다.
export OPENROUTER_API_KEY="발급받은 키"
claude
맥과 리눅스 기준입니다. 윈도우 PowerShell에서는 첫 줄 대신 $env:OPENROUTER_API_KEY="발급받은 키"를 입력하면 됩니다. 이렇게 넣은 키는 그 터미널 창에만 남아서 창을 닫으면 다시 입력해야 합니다.
2. 부탁 문장을 붙여 넣습니다
이 폴더의 메일.csv에 회사 대표 메일함으로 온 메일 20통이 있어요. Jev로 메일마다 종류(고객 지원, 영업, 결제, 제휴, 채용, 뉴스레터, 사기)와 답장이 필요한지 판단해서 표로 보여 주세요. Jev가 확신하지 못한 메일은 따로 표시하고, 결과는 결과.csv로도 저장해 주세요. 사용법은 https://openrouter.ai/docs/guides/community/jev-tutorial 에 있고, OpenRouter API 키는 OPENROUTER_API_KEY 환경 변수에 넣어 뒀어요. 키 값은 화면에 출력하지 말아 주세요.Claude Code는 OpenRouter의 Jev 튜토리얼과 분류 예제 문서를 내려받아 읽었습니다. 키가 들어 있는지는 값을 찍지 않고 길이만 확인했습니다. 그다음 메일 20통을 Jev에 보내는 프로그램을 짜서 실행해도 되는지 물었습니다.
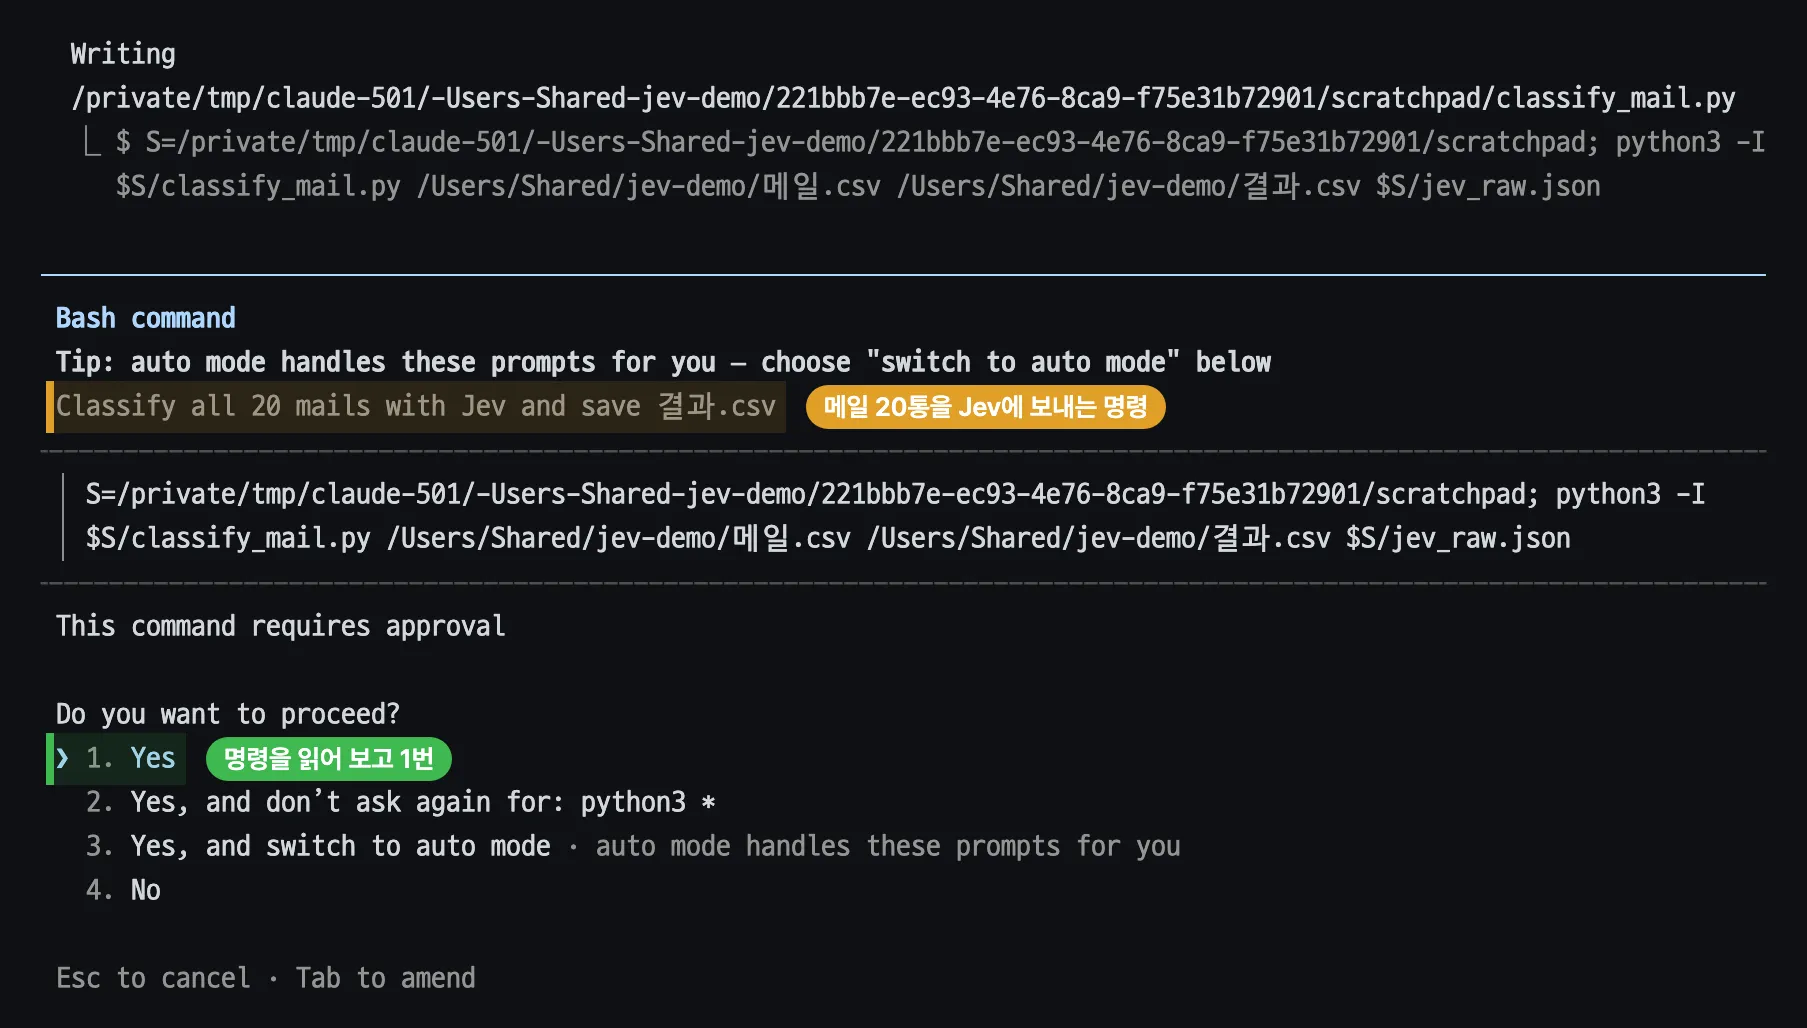 메일을 Jev에 보내기 전에 Claude Code가 허락을 구하는 창입니다. 명령과 그 위 한 줄 설명을 읽어 보고 1번(Yes)을 고르면 됩니다. 2026-10-06 캡처, Claude Code 2.1.291(Opus 5.5).
이 창 전에 문서 두 개를 내려받을 때와 키를 확인할 때 세 번, 끝난 뒤 결과 파일을 확인할 때 한 번 더 허락을 구했습니다. 시연 폴더에는 삭제(rm), 관리자 권한(sudo), 주요 설치 명령(pip install, brew, npm install -g 등), 환경 변수를 찍는 명령(env, printenv 등)을 막는 설정을 넣어 두었습니다. Claude Code가 짠 프로그램은 파이썬 기본 기능만 써서 설치할 것이 없었고 막아 둔 명령을 시도하지도 않았습니다. 이런 설정이 없는 컴퓨터에서 허락 창에 삭제, 관리자 권한, 설치 명령이 보이면 고르기 전에 멈추고 무엇을 하려는지 물어보세요.
3. 결과를 정답과 맞춰 봅니다
부탁부터 표가 나오기까지 허락을 고른 시간을 포함해 2분 26초가 걸렸습니다.
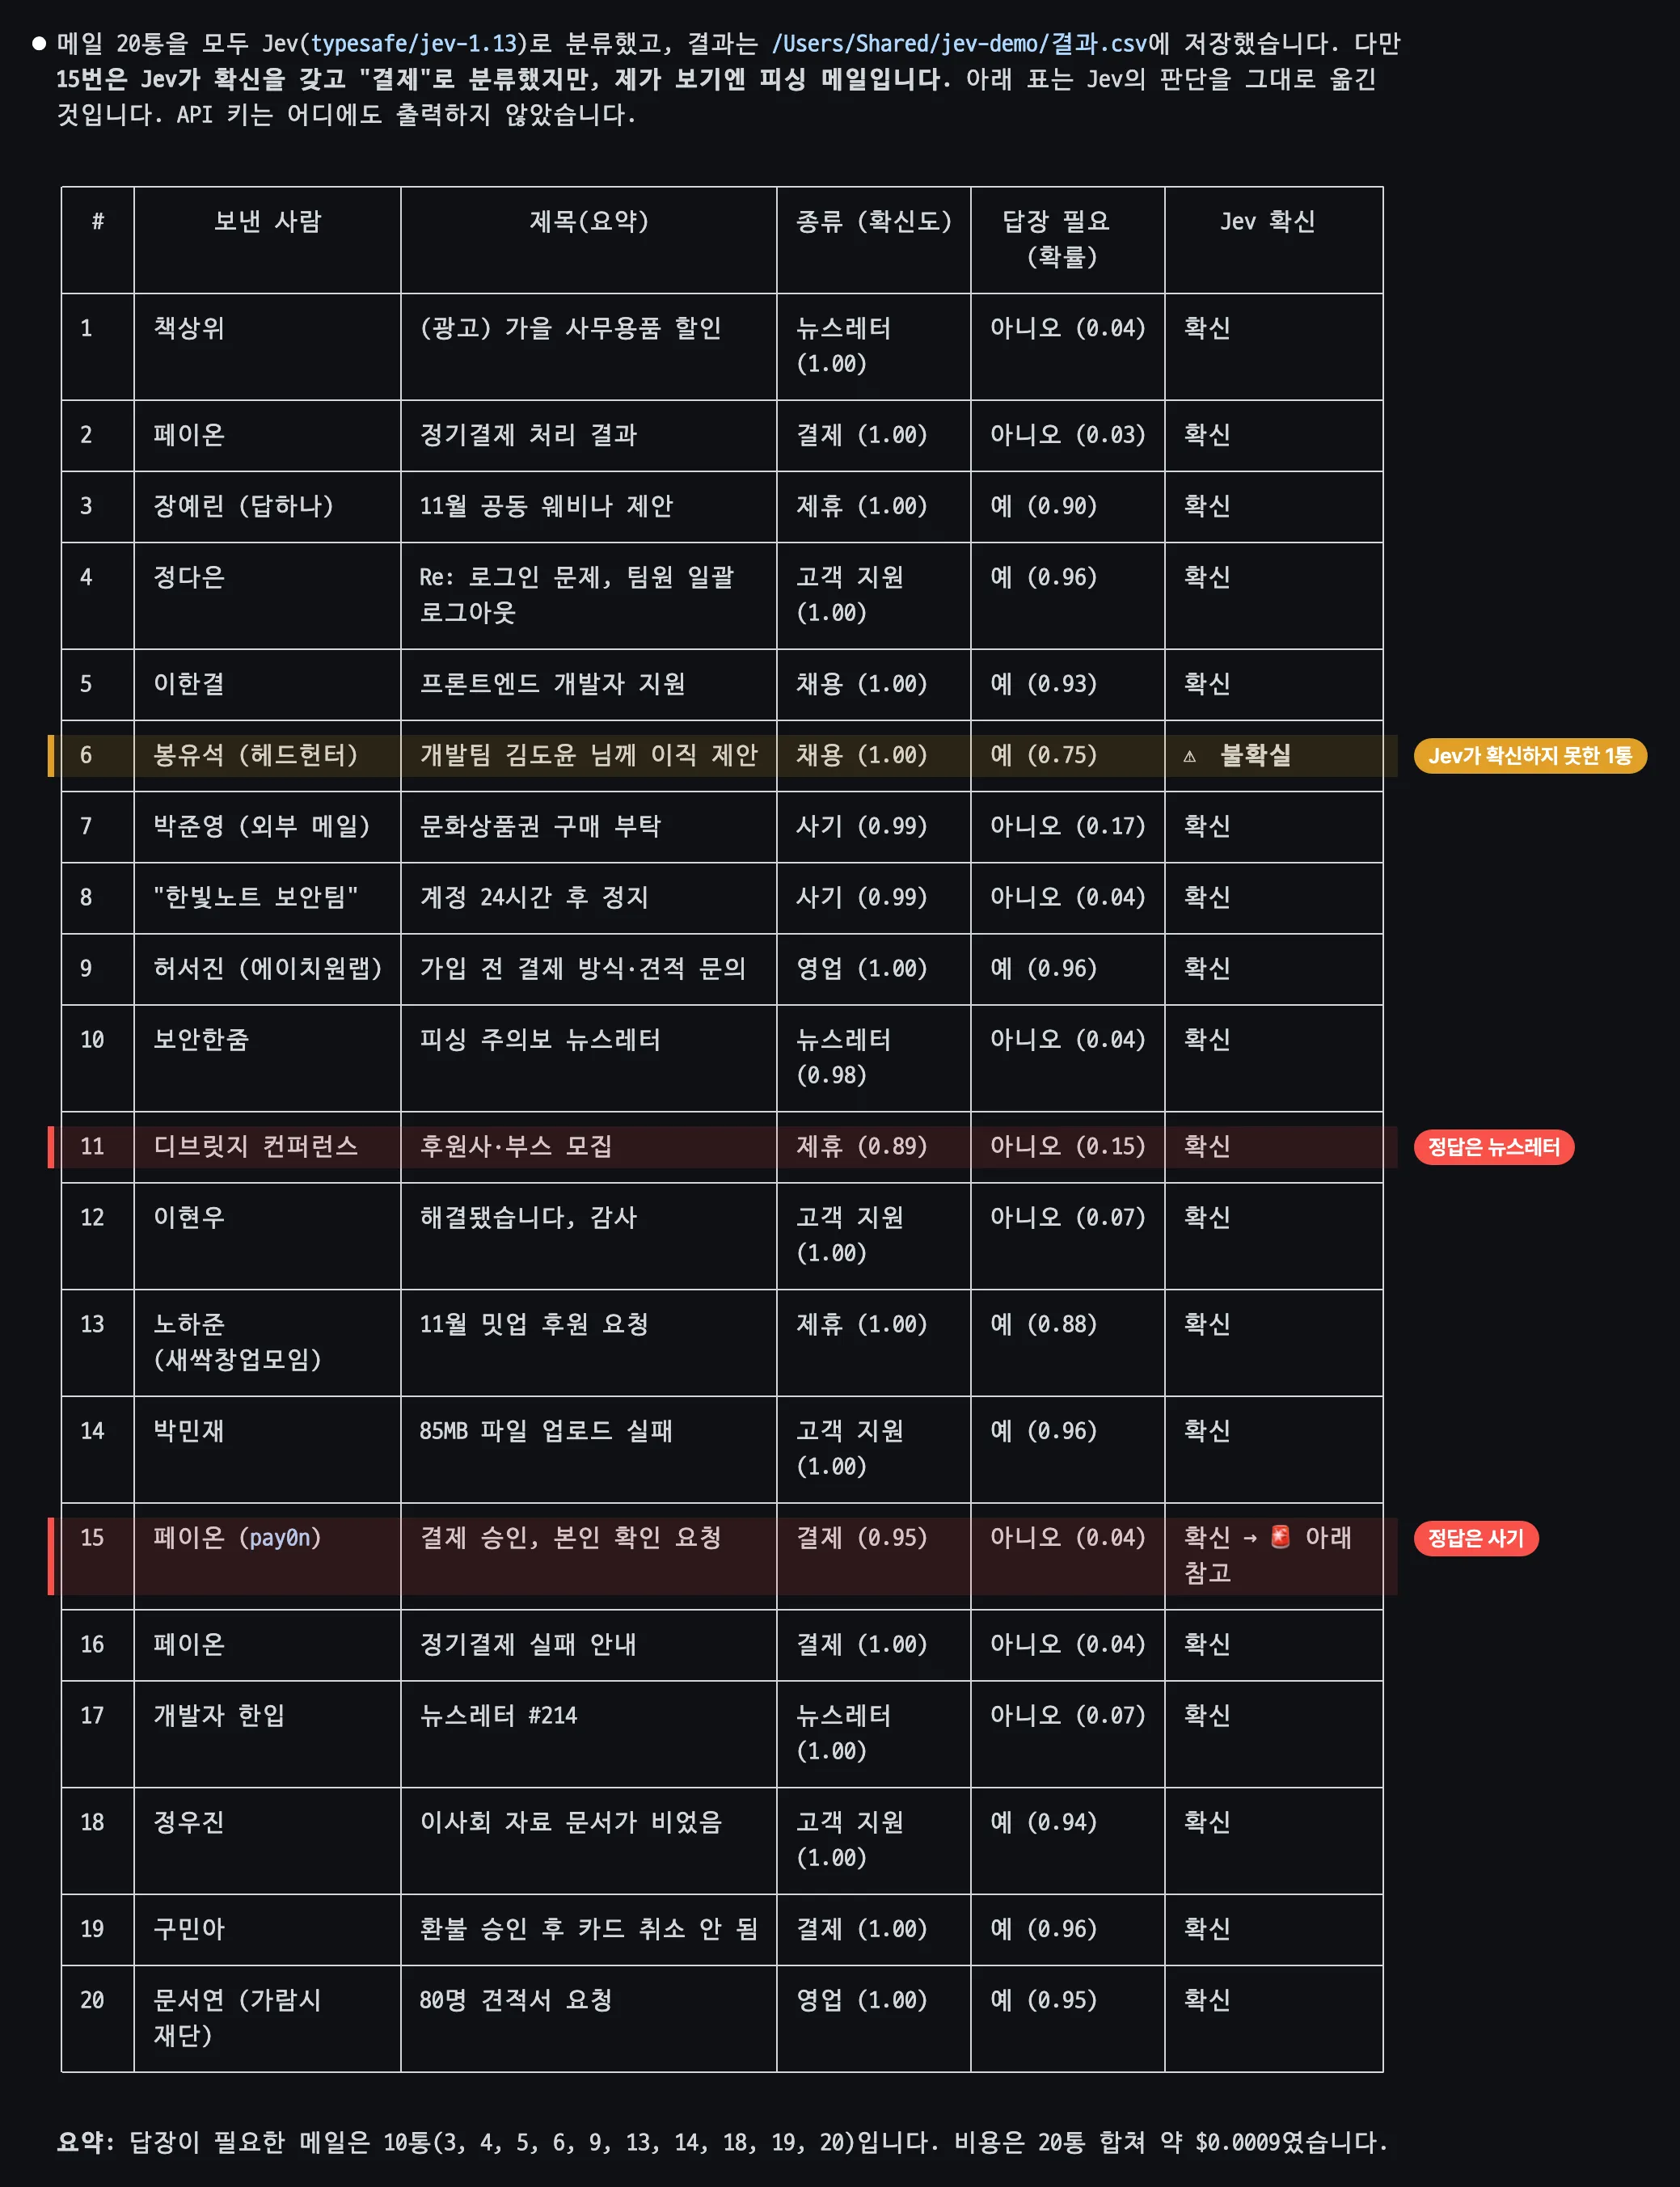 Claude Code가 Jev의 답을 옮긴 표입니다. 빨간 막대는 정답과 다른 메일, 주황 막대는 Jev가 확신하지 못한 메일입니다. 2026-10-06 캡처.
정답과 맞춰 보니 종류는 20통 중 18통, 답장 필요는 20통 모두 맞았습니다. 틀린 2통 중 15번은 120통 실측에서도 Jev가 결제로 본 pay0n 사기 메일입니다.
11번은 여러 회사에 같은 문구로 보낸 컨퍼런스 후원 모집이라 정답은 뉴스레터입니다. 120통 실측에서는 뉴스레터 정의에 “협찬이나 제휴를 모집하는 내용이어도 일괄 발송이면 여기다”라는 경계를 적었습니다. 그 정의로는 Jev가 이 메일을 맞혔습니다. Claude Code가 이번에 짠 정의는 제휴에 ‘행사 후원’을 넣었고 그 경계는 없었습니다. Jev는 적힌 기준대로 판단하므로, 헷갈리는 경계는 글로 적어 줘야 합니다.
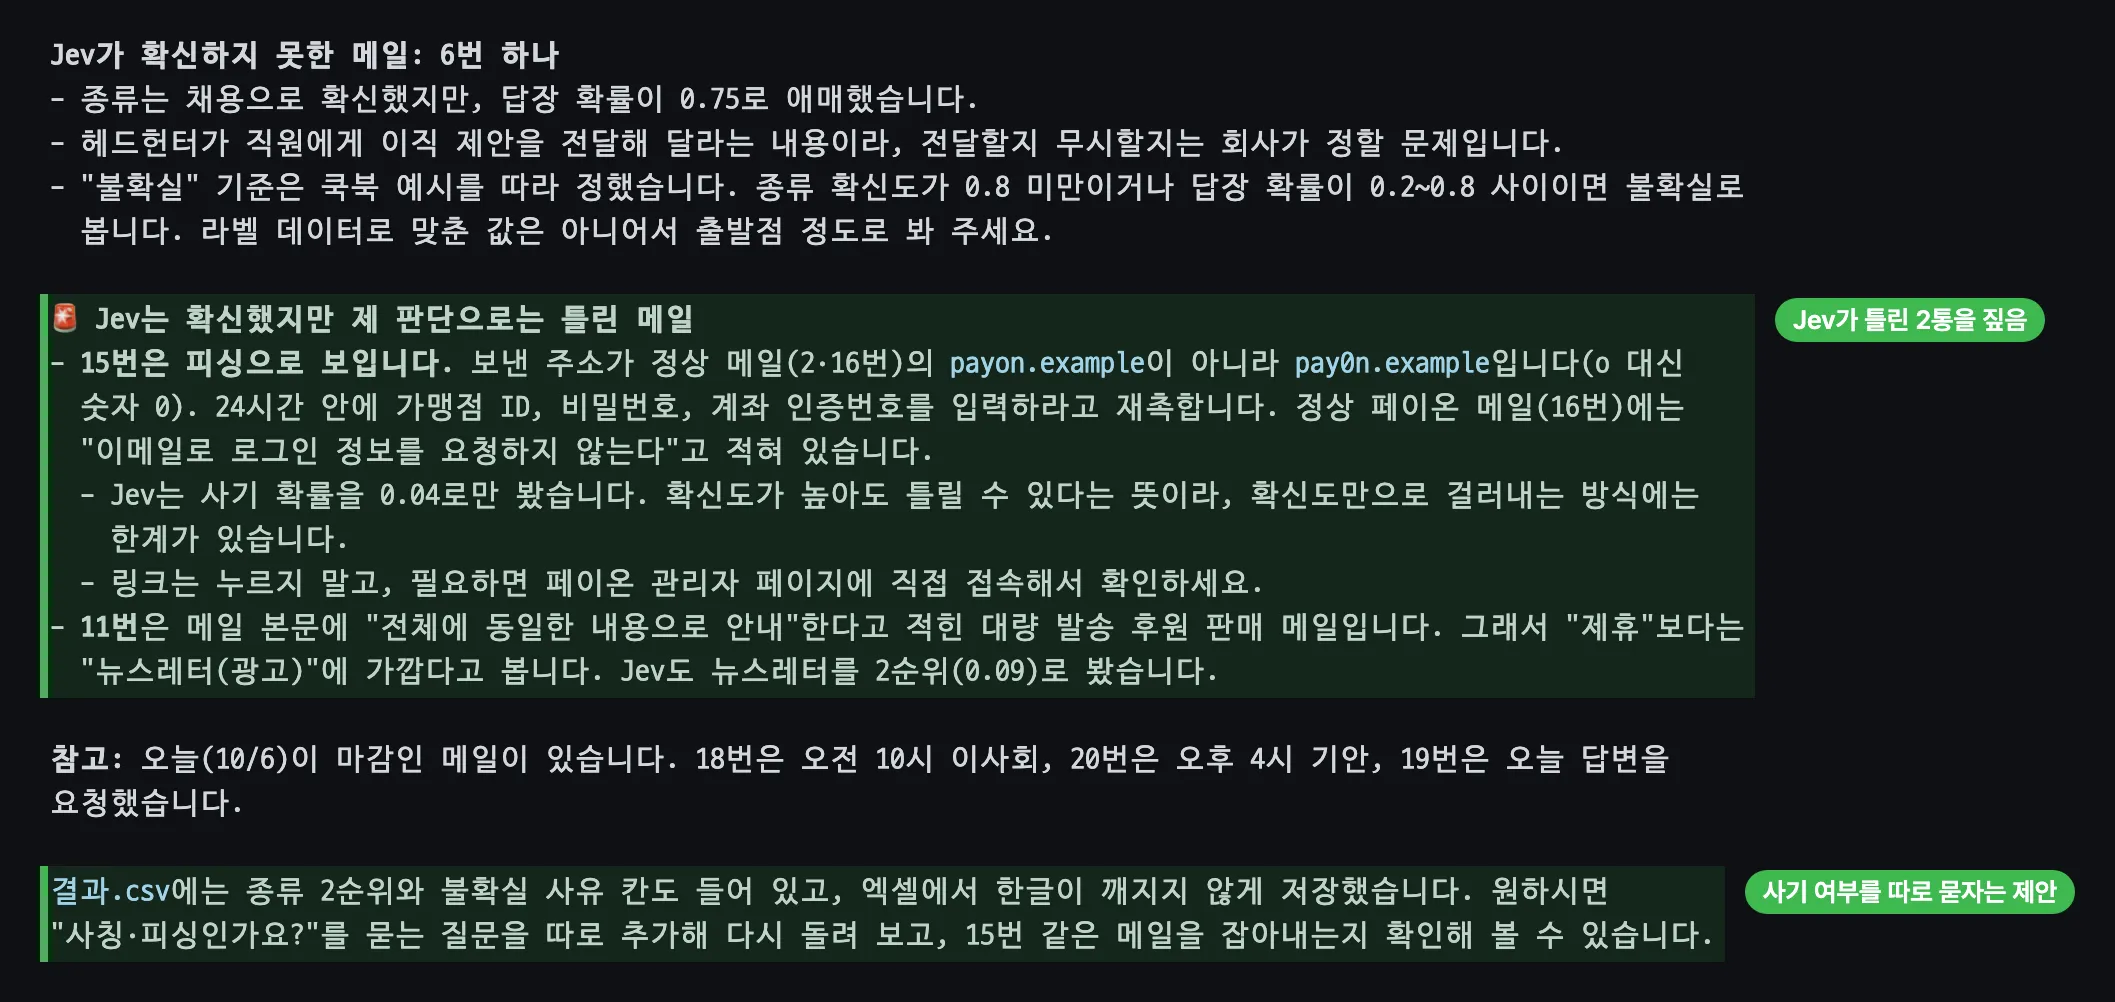 표 아래에 Claude Code가 덧붙인 설명입니다. 초록 막대는 Claude가 메일을 직접 읽고 Jev의 오답을 짚은 곳입니다. 2026-10-06 캡처.
두 통 모두 Jev의 확신도는 0.89, 0.95로 Claude Code가 정한 기준(0.8)을 넘었습니다. 그런데도 Claude Code는 메일 본문을 직접 읽고 두 통이 틀렸다고 표 아래에서 먼저 짚었습니다. 사기 여부를 묻는 질문을 따로 붙여 다시 돌려 보자는 제안도 했습니다. 이 제안은 판단 하나에 질문 하나에서 120통으로 해 본 것과 같은 방향입니다. 어느 에이전트를 쓰든 결과는 메일 원문과 한 번 맞춰 보고 쓰세요.
어디에 쓰고 어디에 쓰지 말까?
메일 분류만 보고 판단하기는 이릅니다. TypeSafe가 만들어 공개한 평가 사이트는 보안 경보 처리, 상담 에이전트 기록 검토, 송장 처리, 고객 문의 응대 네 가지 업무를 여러 모델로 돌린 결과를 보여 줍니다.
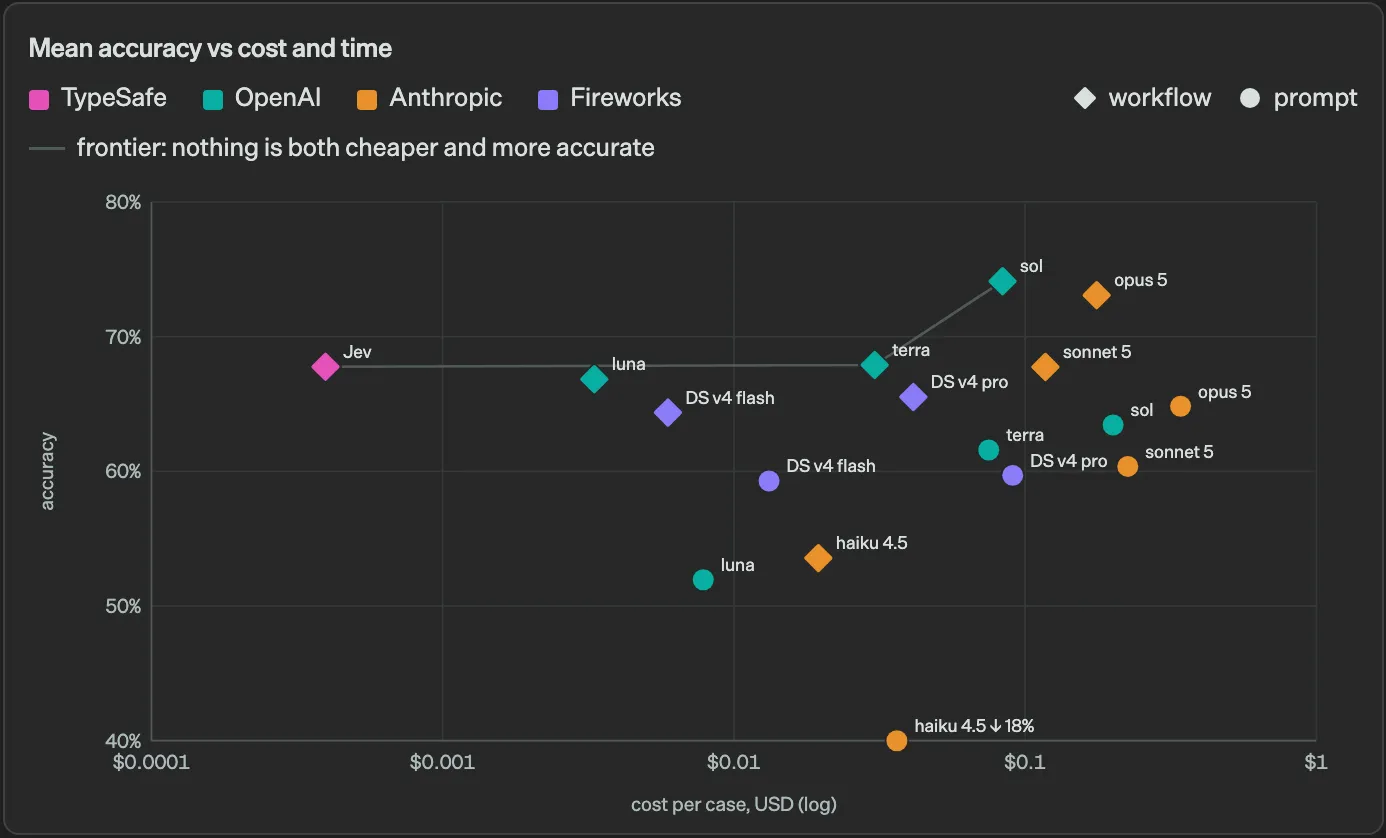 TypeSafe가 만든 평가 사이트의 업무 네 가지 평균 차트입니다. 왼쪽 위로 갈수록 싸고 정확합니다. 마름모(workflow)와 원(prompt)은 사이트가 나눈 두 가지 호출 방식입니다. 본문의 수치는 마름모 값입니다. 2026-10-06 캡처.
네 업무 평균으로 Jev는 정확도 67.8%, 건당 0.0004달러, 0.4초였습니다. 이번 실측의 비교 대상인 GPT-6 Luna는 66.8%에 0.0033달러, 12.9초로, 메일 실측과 달리 Jev가 조금 앞섰습니다. Claude Opus 5는 73.1%에 0.1761달러, 37.8초였습니다. 정확도가 Jev와 같은 Claude Sonnet 5는 0.1174달러에 78.1초였습니다. Jev는 정확도가 가장 높은 모델은 아니지만 같은 정확도를 내는 데 드는 비용과 시간이 가장 적었습니다. 여기서 정확도는 사람이 매긴 정답이 아니라 GPT-6 Astra와 Claude Fable 5.1의 판정으로 만든 정답과 일치한 비율입니다.
회사 밖에서 잰 결과도 있습니다. ML6는 공개 데이터셋 두 개의 메일 15,728통으로 피싱과 스팸을 가렸습니다. 메일 한 통의 응답 시간 중앙값은 Jev 0.30초, GPT-6 Luna 약 2초였고 전체 비용은 0.34달러 대 1.48달러였습니다. 회사가 내세운 배수만큼은 아니어도 약 7배 빠르고 값은 4분의 1도 안 된다고 적었습니다. 정확도는 피싱 99.99% 대 99.96%, 스팸 95.06% 대 92.82%로 Jev가 같거나 조금 높았습니다. 사기 메일을 놓친 이번 실측과 다른 결과인데 공개 데이터셋과 이번 한국어 합성 메일은 조건이 달라 그대로 견주기는 어렵습니다.
맡기기 좋은 일
- 답이 몇 가지로 정해진 판단을 많이 할 때: 메일과 문의 분류, 담당자 배정, 우선순위 매기기
- 다른 AI의 결과를 빠르게 거를 때: 검색 결과가 질문과 관련 있는지, 에이전트가 사람에게 넘겨야 하는 상황인지
- 확률을 보고 사람이나 LLM에게 넘길 것을 고를 때: 확신도를 보고 어디까지 맡길까?에서 본 방식
맡기지 않는 게 좋은 일
- 글쓰기, 요약, 번역, 코드: Jev는 글을 만들지 않습니다. 답장 초안은 LLM에 맡기면 됩니다
- 계산, 개수 세기, 날짜 비교: 공식 문서는 이런 일은 코드로 하라고 권합니다
- 속이려고 쓴 글을 Jev 혼자 가려내는 일: 이번 실측의 사기 메일처럼 놓칠 수 있습니다
- 판단과 상관없는 내용이 많이 섞인 긴 자료: 공식 문서는 필요한 부분만 골라 보내라고 권합니다
쓰기 전에 알아둘 점
다만 Jev가 돌려준 숫자를 그대로 믿고 맡기기 전에 알아둘 것이 있습니다.
한국어와 보기 순서
공식 문서는 영어가 가장 정확하고 한국어 같은 다른 언어는 같은 수준이 아니라고 적었습니다. 내 자료로 먼저 시험하고 확신도를 눈여겨보라고도 권합니다. 메일 본문은 한국어 그대로 두고 질문, 보기 정의, 메일함 설명을 영어로 바꿔 한 번 더 재 봤습니다. 메일 종류는 93.3%, 답장 필요는 90.0%로 한국어 질문(95.0%, 91.7%)보다 조금 낮았고 긴급도는 88.3%로 조금 높았습니다(85.8%). 비용은 입력 토큰이 줄어 17% 적었습니다. 이번 메일에서는 질문을 영어로 바꿔도 정확도가 뚜렷하게 오르지는 않았습니다.
보기 순서에 따라 답이 달라질 수 있다는 경고도 문서에 있습니다. 종류 보기 7개의 순서를 뒤집어 돌렸더니 120통 중 1통의 답이 바뀌었습니다. 이번에는 틀렸던 답이 정답으로 바뀌었습니다.
업무에 붙이기 전에
공식 문서에는 수요가 많아 호출 한도(초당 토큰 수와 요청 수)가 예고 없이 바뀔 수 있다는 안내가 있습니다. OpenRouter에서 Jev를 부르는 주소(/api/alpha/decisions)도 이름대로 알파 단계입니다.
실제 회사 메일을 넣으면 메일 내용이 OpenRouter와 TypeSafe로 전송됩니다. Claude Code로 돌리면 메일을 읽는 과정에서 Anthropic으로도 전송됩니다. 회사 규정을 먼저 확인하세요. TypeSafe는 고객의 요청과 응답으로 모델을 학습시키지 않는다고 문서에 밝혔습니다.
NomaDamas가 Jev로 해 본 것
한국어 데이터로 학습시킨 작은 모델은 Jev와 얼마나 차이가 날까요? Jev가 나오고 나흘 뒤인 9월 19일, 저희 NomaDamas 리더 김동규는 한국어 판단 모델을 만들어 보는 실험 저장소 KoJev를 열었습니다. 바탕은 SK텔레콤이 공개한 한국어 인코더 모델(A.X-Encoder-base)입니다. 인코더 모델은 글을 쓰지 않고 글을 읽어 뜻을 숫자로 바꾸는 모델이라 분류에 많이 쓰입니다. 이 모델을 한국어 공개 데이터 12종에서 뽑은 약 10만 4천 건으로 학습시켜, Jev처럼 자료와 질문을 넣으면 확률이 나오게 만들었습니다.
| 시험 (각 80건) | KoJev | Jev 1.13 |
|---|---|---|
| 자체 검증 데이터 | 0.702 | 0.769 |
| KoBEST BoolQ (예, 아니요 질문) | 0.500 | 0.988 |
| KoBEST COPA (원인과 결과 고르기) | 0.538 | 0.988 |
| KoBEST WiC (같은 단어의 뜻 구별) | 0.463 | 0.888 |
| KoBEST HellaSwag (이어질 문장 고르기) | 0.338 | 0.775 |
| KoBEST SentiNeg (부정문 감정 판단) | 0.525 | 0.938 |
KoJev 저장소 README의 표 중 KoJev와 Jev 1.13 열입니다. 숫자는 정답률입니다. KoBEST는 1이면 80문항을 모두 맞힌 것입니다. 보기가 둘인 시험은 아무렇게나 찍어도 0.5 안팎, 보기가 넷인 HellaSwag는 0.25 안팎이 나옵니다.
Jev 1.13이 모든 시험에서 앞섰습니다. KoJev는 학습한 데이터와 비슷한 문제에서는 점수를 냈지만 처음 보는 한국어 시험(KoBEST)에서는 찍는 수준에 가까웠습니다. README에도 “분야 안에서 맞추는 힘은 진짜지만 일반화는 아니다”라고 적었습니다. 반대로 Jev 1.13은 같은 KoBEST 시험에서 0.78~0.99를 냈습니다.
10월 5일에는 저희를 운영하는 Markr의 오픈소스 AutoRAG에 Jev 판단 도구가 들어갔습니다(PR #1771, 김동규 작성). 문서를 찾아 주는 AutoRAG Agent가 분류, 선별, 순위 매기기 같은 반복 판단을 주 모델 대신 Jev에 맡길 수 있게 한 선택 기능입니다. 기본값은 꺼져 있습니다. 글쓰기, 답이 정해지지 않은 질문, 너무 긴 자료처럼 Jev가 판단하기 어려운 경우나 확신이 낮은 경우에는 직접 정하지 않고 넘기라는 표시를 붙여 돌려줍니다. 확신도를 보고 넘길 것을 고르는, 이번 실측에서 본 쓰는 법과 같습니다. 이 기능은 10월 7일에 나온 정식 배포판 v2.8.0부터 들어 있습니다.
마치며
Jev는 글 쓰는 AI를 대신하지 않습니다. 이번 실측에서 Jev는 정해 둔 질문에 답하는 일을 GPT-6 Luna보다 10배 빠르게, 약 절반 값에 하면서 보기마다 확률도 돌려줬습니다. 대신 속이려고 쓴 글에는 약했습니다. Jev는 많은 양을 빠르고 싸게 나누고 얼마나 확신하는지를 숫자로 알려 주는 AI입니다. 그 숫자를 보고 어디까지 맡길지는 사람이 정해야 합니다.
정답을 아는 내 메일 수십 통과 이 글의 부탁 문장이면 Claude Code로 내 메일함에도 맞는지 재 볼 수 있습니다. 실제 메일을 넣기 전에는 업무에 붙이기 전에를 먼저 읽어 주세요.
- Jev 시작하기: OpenRouter Jev 튜토리얼, TypeSafe 문서
- KoJev: github.com/NomaDamas/KoJev
- AutoRAG의 Jev 도구: github.com/Marker-Inc-Korea/AutoRAG. 도움이 됐다면 star를 눌러 주세요
자주 묻는 질문
Jev(제브)는 무료인가요?
출력은 무료이고 입력에만 돈이 듭니다. 입력 100만 토큰당 0.042달러입니다. 이번 실측에서 메일 한 통에 질문 세 개를 묻는 데 평균 1,385토큰, 약 0.00006달러가 들었고 1,000통이면 약 0.058달러입니다.
Jev는 한국어도 되나요?
됩니다. 공식 문서는 영어가 가장 정확하고 한국어 같은 언어는 같은 수준이 아니라고 적었지만 이번 한국어 메일 120통에서 메일 종류를 95.0% 맞혔습니다. 주로 사기 메일처럼 속이려고 쓴 글에서 틀렸습니다. 내 자료로 먼저 재 보고 확신도가 낮은 답은 따로 확인하세요.
질문을 영어로 쓰면 더 정확한가요?
이번 실측에서는 뚜렷하지 않았습니다. 메일 본문은 한국어로 두고 질문과 설명만 영어로 바꿨더니 메일 종류 93.3%, 답장 필요 90.0%로 한국어 질문(95.0%, 91.7%)보다 조금 낮았고 긴급도는 88.3%로 조금 높았습니다(85.8%). 비용은 17% 적었습니다. 한 번 잰 값이고 메일이 다르면 결과도 달라질 수 있습니다.
ChatGPT나 Claude 대신 쓸 수 있나요?
대신하지 않습니다. Jev는 글을 쓰지 않아서 답장 초안, 요약, 번역은 못 합니다. 메일을 나누는 일은 Jev에, 답장 쓰기는 LLM에 맡기는 식으로 나눠 쓰면 됩니다.
What is Jev by TypeSafe AI, and does it work in Korean?
Jev is a “System One” decision model that TypeSafe AI released on September 15, 2026. Instead of generating text, it answers typed questions (Choice, Noul, Score) with probabilities. On 120 synthetic Korean emails, Jev was about 10x faster than GPT-6 Luna at about half the cost, with 95.0% category accuracy versus 100%. Most of its misses were phishing emails disguised as normal ones.
참고 자료
공식 자료
- TypeSafe AI 홈페이지, Introducing System One Models and Jev
- TypeSafe 문서: 모델과 언어 지원, Jev 1.13의 약점(jaggedness), 질문 종류, 확신도
- TypeSafe 평가 사이트
- OpenRouter Jev 튜토리얼
반응과 독립 측정
- 해커뉴스 발표 글, Jev in 25 Lines of Python
- Latent Space: Here are 6 Clones of Jev in 2 days
- Jev in the Wild (논문)
- ML6: Jev vs GPT-6 Luna vs BERT
- OpenAI DevDay 2026 정리, Databricks ai_decide 소개, Cloudflare Clef 소개
NomaDamas
갱신 이력
- 2026-10-07 최초 발행
이 글은 AI의 도움을 받아 작성했습니다. 시연 메일과 정답은 Claude로 만든 합성 데이터입니다. KoJev와 AutoRAG의 Jev 도구는 저희 NomaDamas 리더 김동규가 만들었고 AutoRAG는 저희를 운영하는 Markr의 프로젝트입니다.